效果截图
从登录到看板,从配置到日志,每个环节都有清晰的界面
登录:本地账号或企业统一认证
默认使用用户名 + 密码,右上角可随时切换主题与语言。启用外部认证后,登录页按所选方式自动切换为门户引导页,本地表单仍在 /login/local。默认口令没改之前,登录后每个页面顶部都会挂一条红色警告。
- 初始账号
admin和view - 密码 BCrypt 单向哈希存储
- 管理员/访客两级权限体系
- 支持 OA 接口校验、网关头、票据 SSO,可关闭本地登录
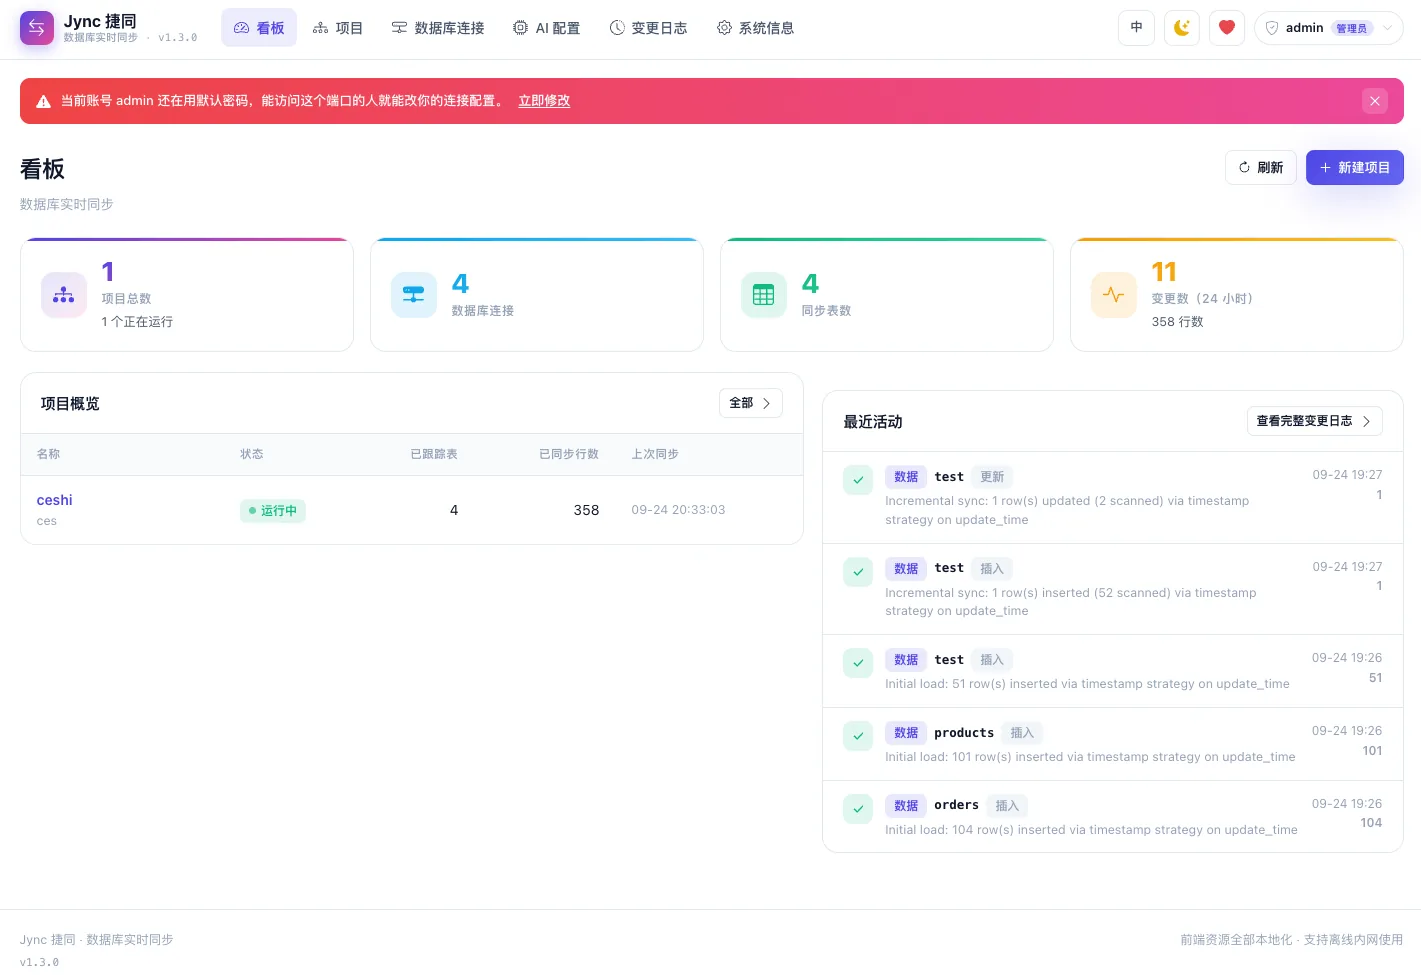
看板:全局同步态势一屏掌握
同步任务数、ETL 任务、数据库连接与 24 小时变更量一屏总览;管理员另见负载、CPU、内存与磁盘,以及进程 CPU / 堆内存 / GC 趋势曲线。
- 全局数据概览,表头与数值逐列对齐
- 进程资源只统计本服务器上的任务,趋势可切换 1 小时 / 24 小时 / 7 天
- 进程与主机样本按
metrics.app-interval-ms采集(默认 1 分钟),历史保留metrics.retention-days(默认 7 天) - 同步任务概览 / 最近活动各只列前 5 条,底部入口跳转完整列表
- 快速导航到各模块
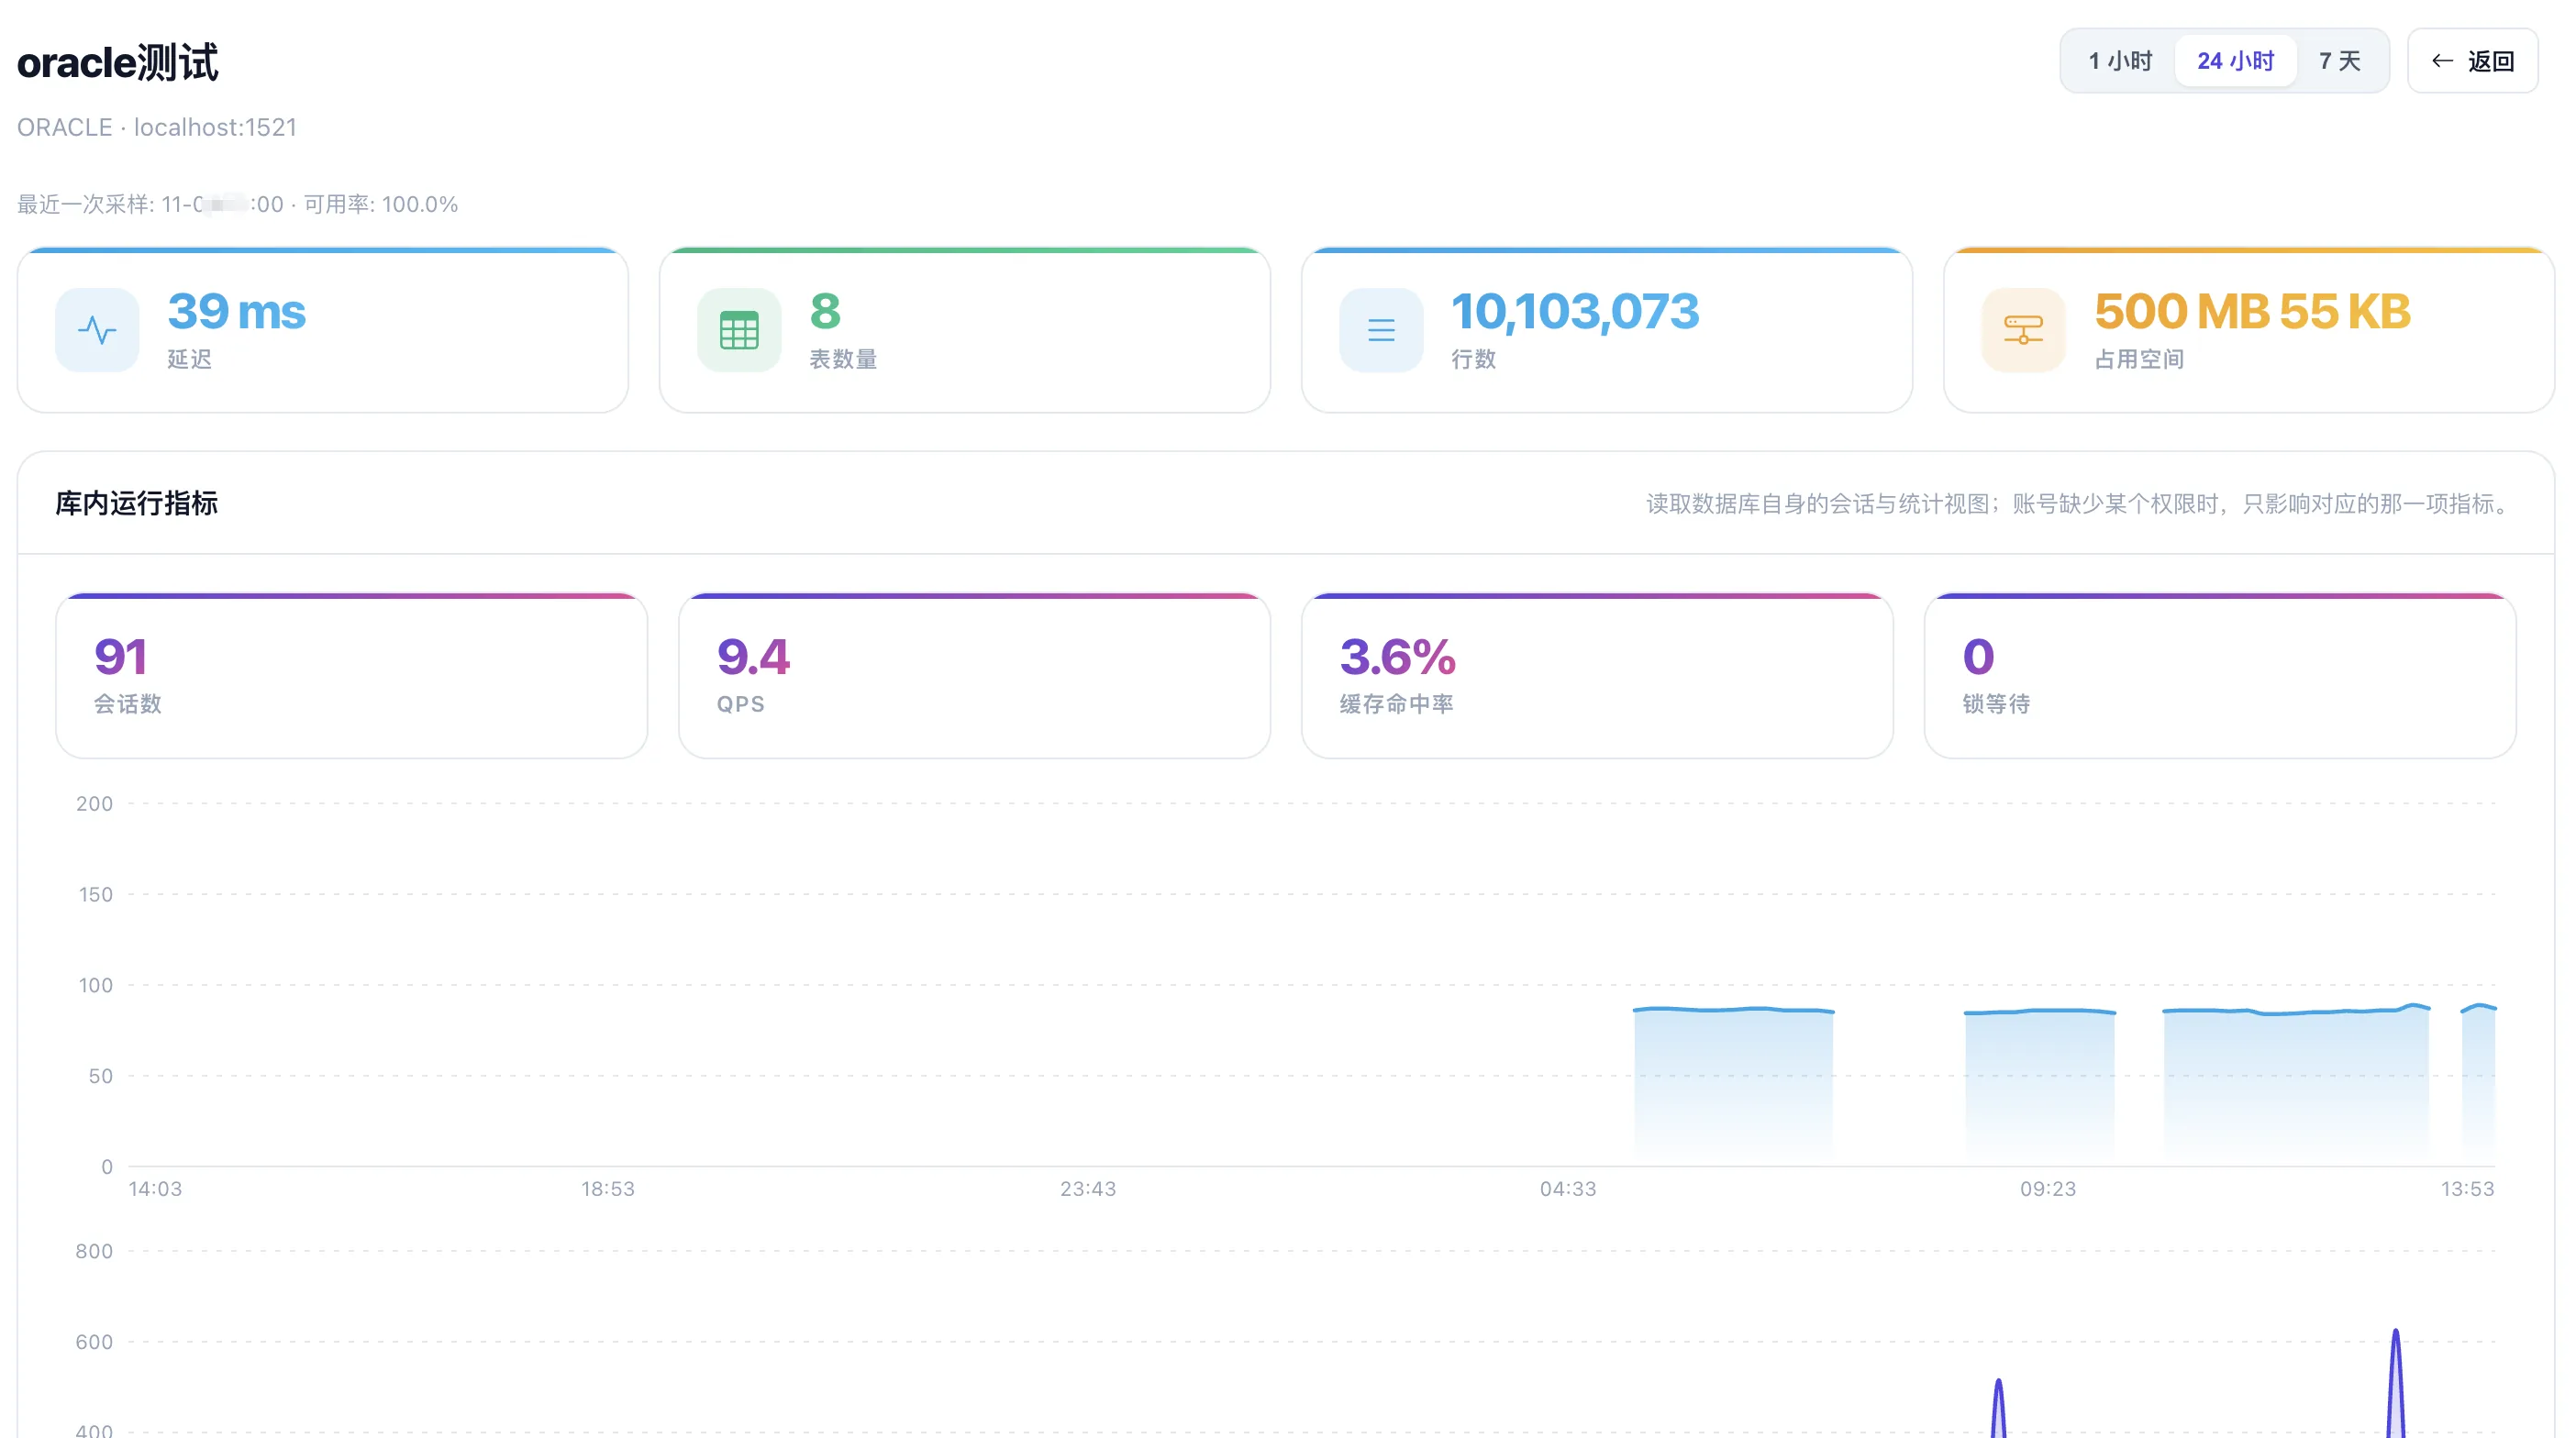
数据库性能:延迟、库内指标与容量曲线
点连接列表里的折线按钮进入该连接的数据库性能页:连接延迟与可用性,会话数 / QPS / 缓存命中率 / 锁等待,以及表数、行数与占用空间曲线,可切换 1 小时 / 24 小时 / 7 天。
- 曲线由后台采样器写入元数据库,打开页面不临时查询业务库
- 库内指标读取数据库自身的会话与统计视图;账号缺少某项权限,只影响对应指标
- 目录统计只对 MySQL、Oracle、SQL Server、PostgreSQL、DB2 可用,其余产品容量显示「—」
- 采样间隔
metrics.db-interval-ms(默认 5 分钟)与metrics.capacity-interval-ms(默认 1 小时)可调;不需要时关闭metrics.enabled
同步任务性能:行数、延迟与变更构成
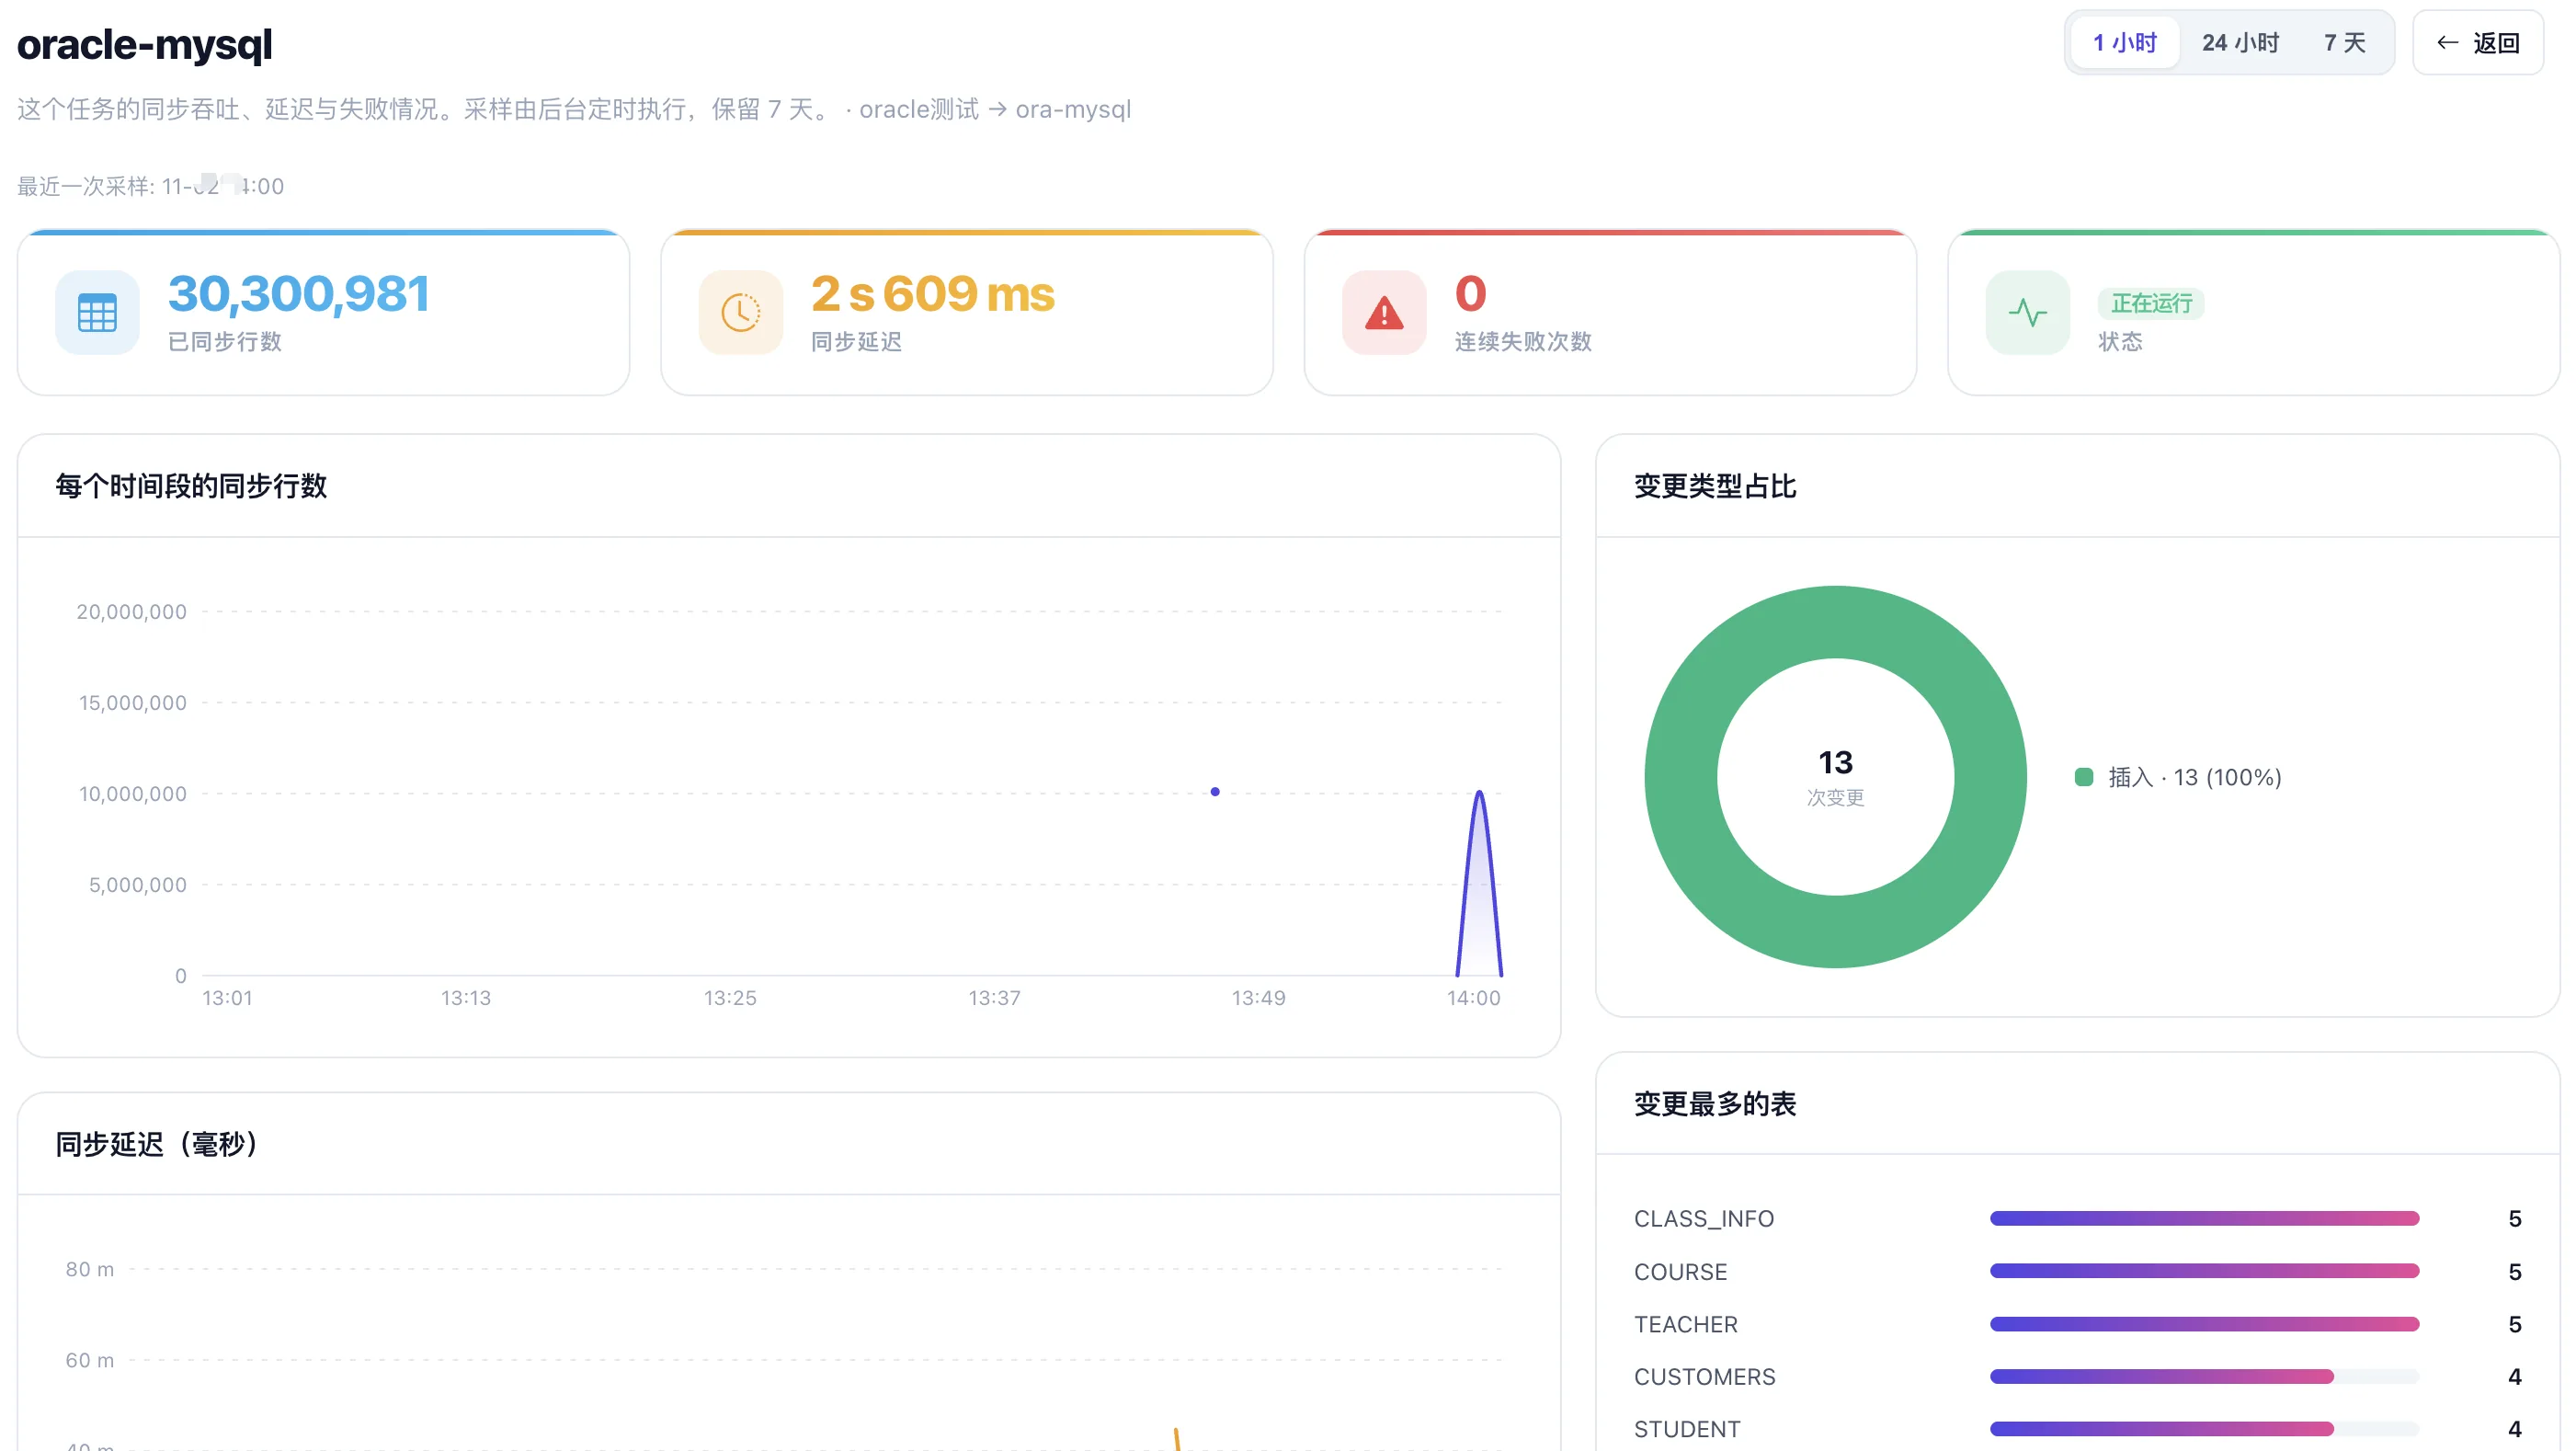
每个同步任务都有独立性能页:已同步行数、同步延迟、连续失败次数与运行状态,下方是「每个时间段的同步行数」「变更类型占比」「变更最多的表」。
- CDC 任务的延迟按源提交时刻计算,源库空闲时显示 0,重连追赶的事件不计入
- 变更类型占比区分插入 / 更新 / 删除,变更最多的表直接列出次数
- 没有采样的时间桶保持断线、不补零,曲线不会被「假的 0」拉平
- 采样间隔
metrics.task-interval-ms(默认 1 分钟)可调;历史默认保留 7 天(metrics.retention-days),采样关闭后已存样本仍可查看
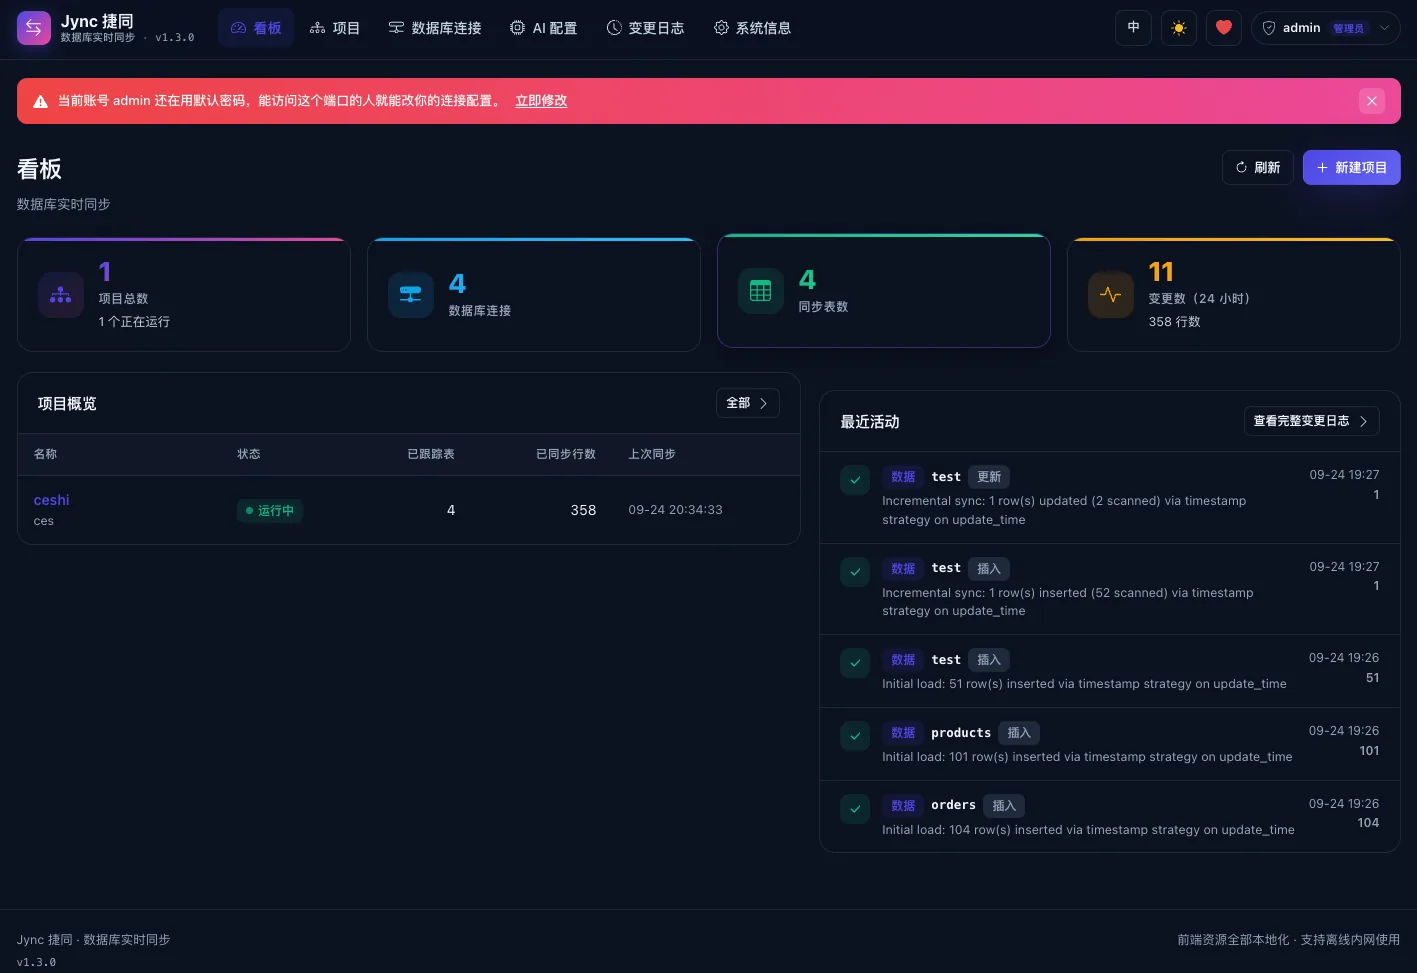
暗色主题:整套配色一起换
右上角一键切换。看板、卡片、表格、图标都跟着走,不是只把背景刷黑、留下一片刺眼的浅色控件。
- 仅覆盖 CSS 变量,组件无需第二套深色规则
- 未手动选择时跟随系统偏好
- 监听系统主题变化实时跟随
- 切换按钮的月亮 / 太阳图标固定金黄色,昼夜两种底色下都醒目
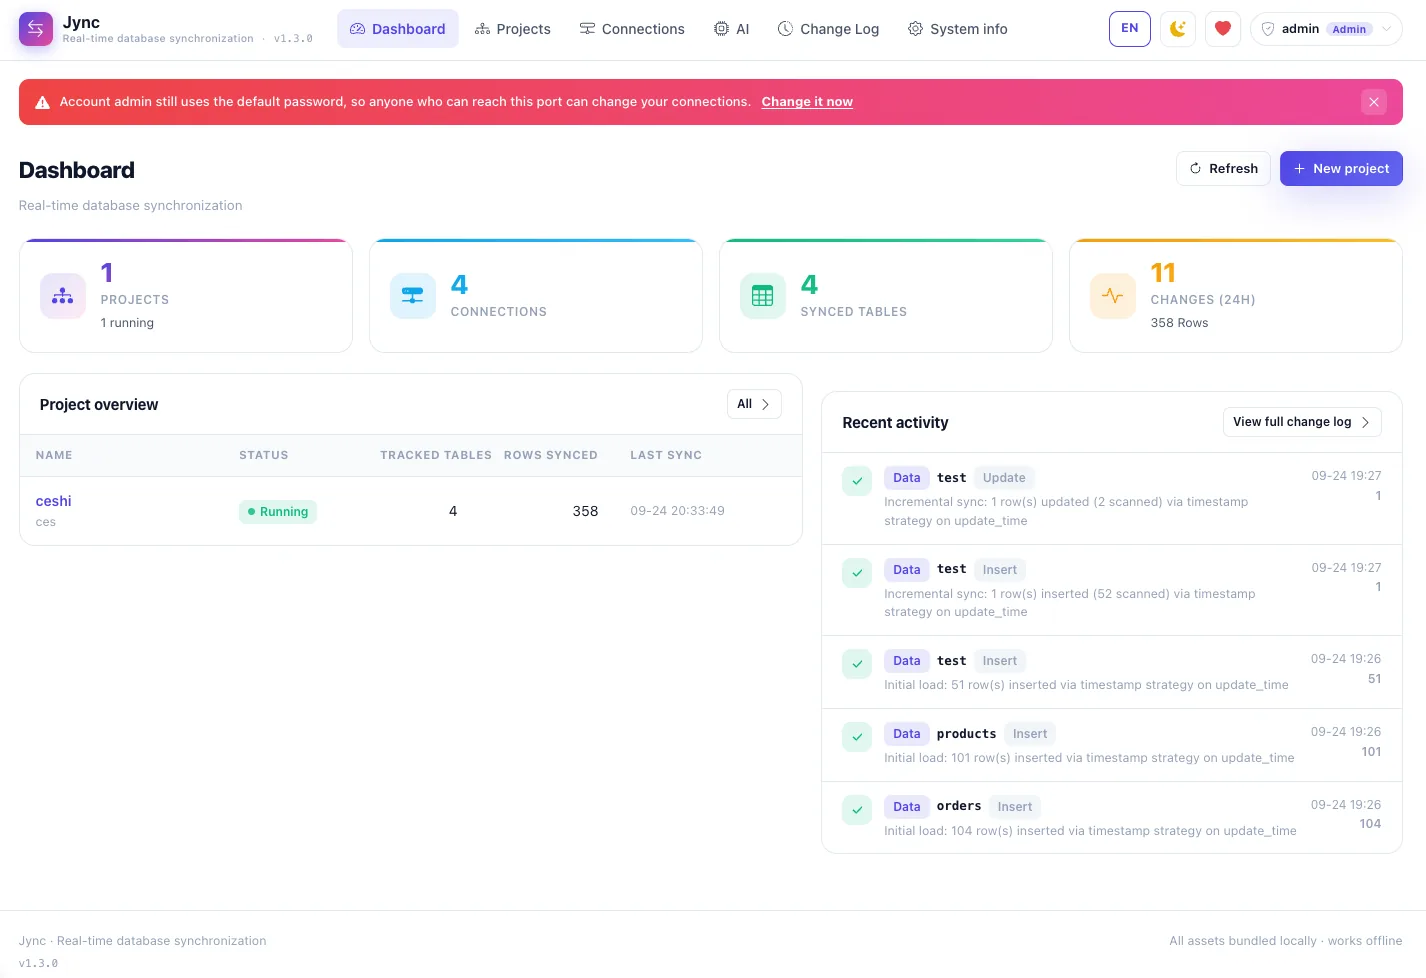
英文界面:右上角一键切换
点导航栏的「中 / EN」按钮即可在中英文之间切换,菜单、表单、状态与错误提示整套文案一起换,选择记在浏览器里。首次访问未手动选择时,默认语言按浏览器时区智能推断。
- 菜单 / 表单 / 状态 / 错误提示整套文案一起换
- 优先级:语言 Cookie › 浏览器时区 › Accept-Language
- 境外华人用户的时区往往比浏览器语言更准
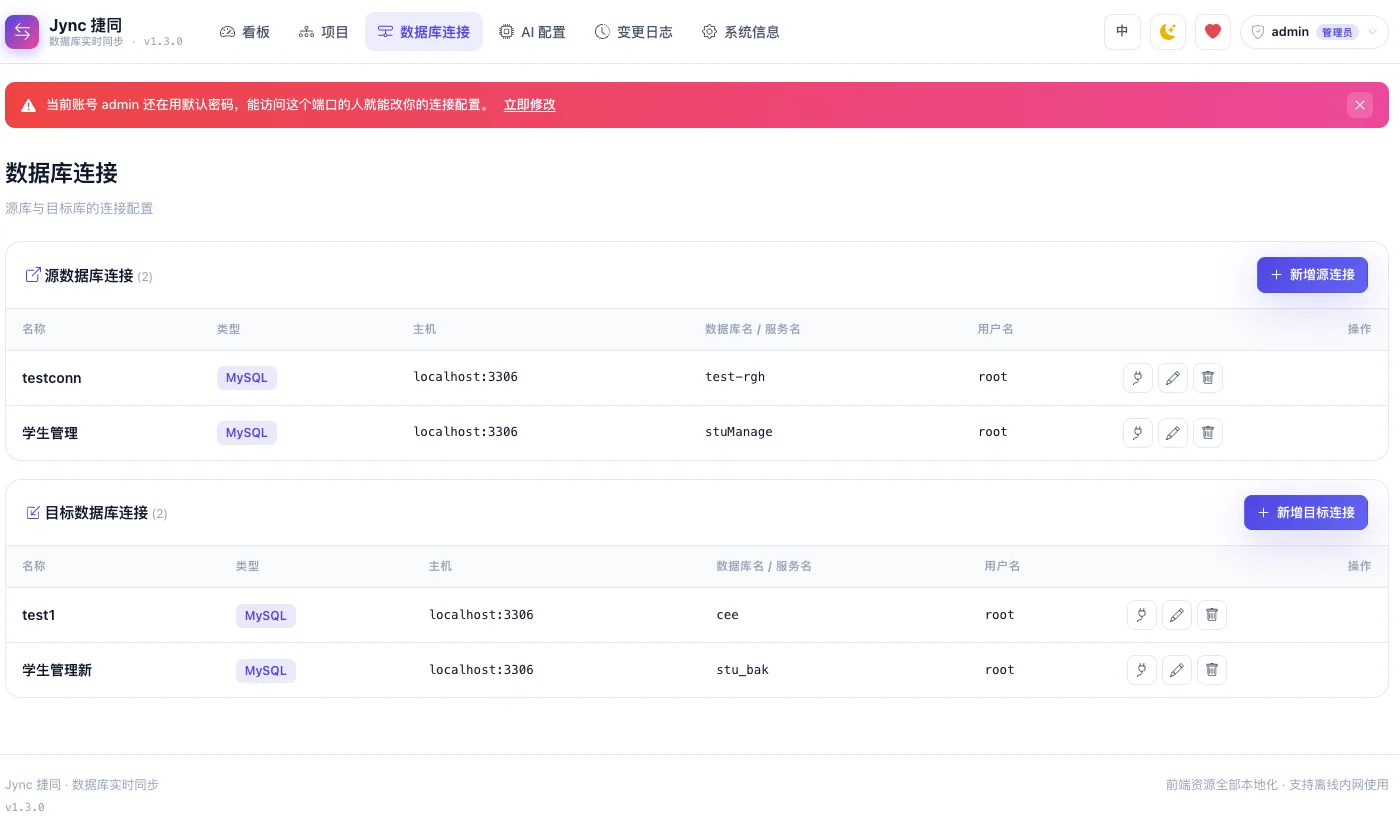
数据库连接:源 / 目标分栏,保存前先测通
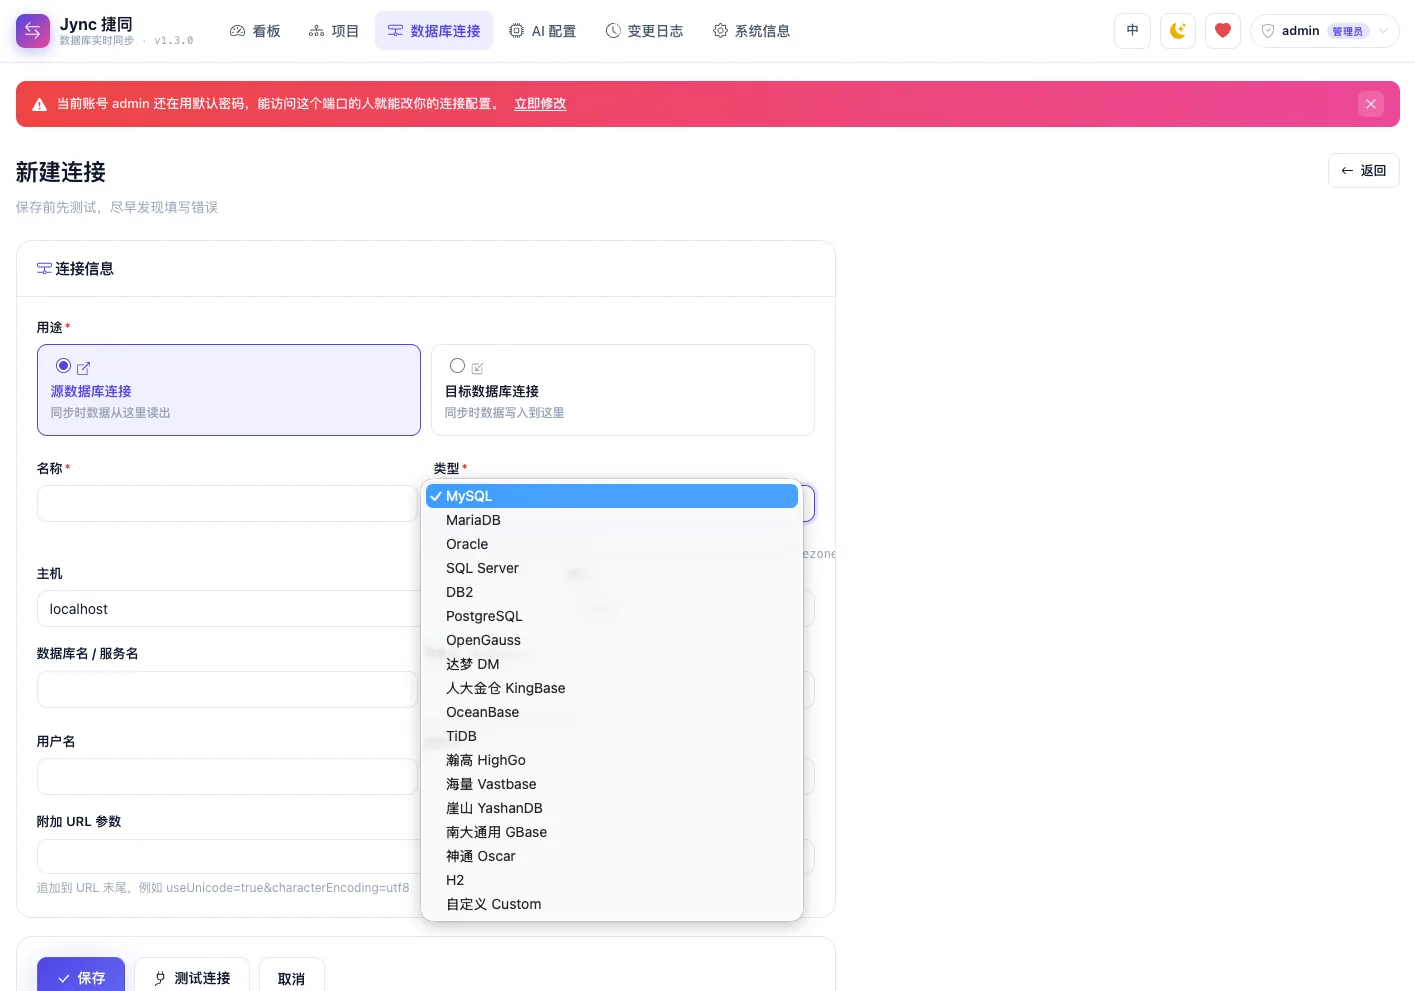
连接按用途拆成「源数据库连接」「目标数据库连接」两张表,各自独立分页;同步任务表单的源、目标下拉只会列出对应一侧的连接,不会把只该写入的库错选成源。每一行都可以直接测试、编辑或删除,密码加密后入库。
- 新建连接必须选择用途:源(数据读出)/ 目标(数据写入)
- 测试连接会真正建立连接并执行一次轻量查询,先测通再保存
- 被同步任务引用的连接不能删除,需要先处理相关同步任务
- 每行的折线按钮直达该连接的数据库性能页:延迟、可用性、库内指标与容量曲线
- 外部驱动通过独立 URLClassLoader 加载,不污染应用类加载器
新增连接:34 种类型,选好 URL 自己拼
先定用途,再从 34 种预置类型中选择数据库(含 OceanBase、GaussDB、GoldenDB、TDSQL、PolarDB、瀚高、海量、崖山等信创库,以及 SAP HANA、Doris、ClickHouse、Hive、Impala、Elasticsearch、MongoDB 等分析型引擎(SAP HANA 支持实时同步,其余六种可作实时同步源));默认端口随类型联动,填好主机、端口、库名后 JDBC URL 当场生成,不用记各家连接串格式。
- MySQL / PostgreSQL 协议产品复用对应驱动,按实际端口改即可
- SQL Server 命名实例可留空端口,主机写
主机名\实例名或附加instanceName - GBase / 神通 / GaussDB / 自定义类型可填驱动 jar 路径或目录,运行时动态加载
- 类型切换时自动清理上一种类型的驱动覆盖,避免残留值误提交
同步任务列表:多任务并行,启停自如
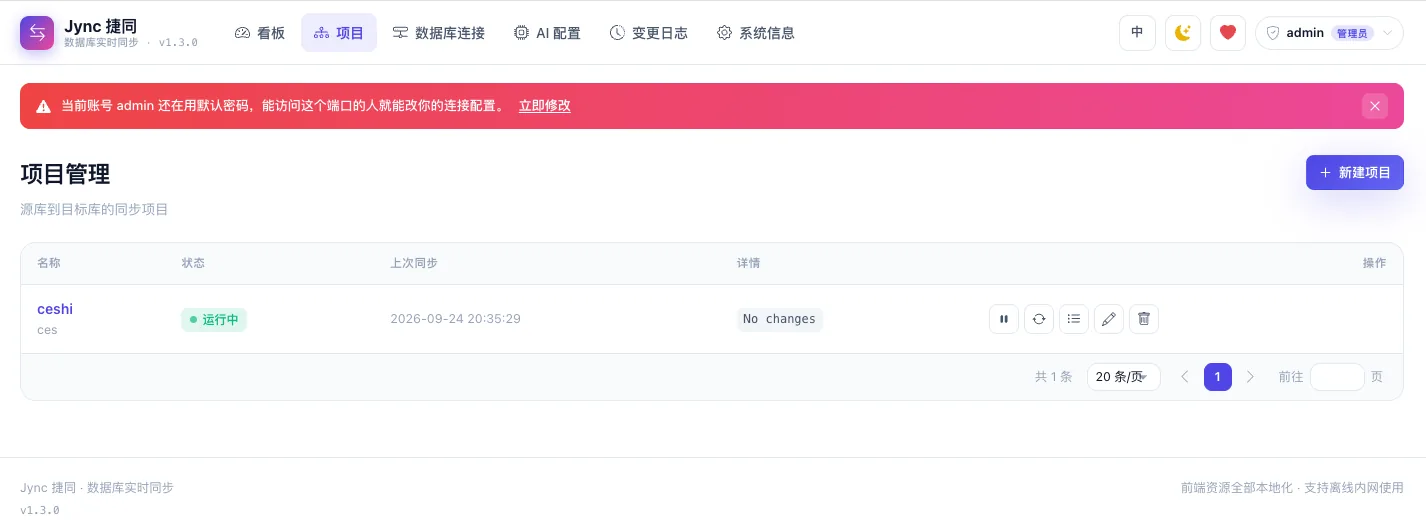
每个同步任务一组「源库 → 目标库」,独立启动/暂停,状态与最近同步时间一目了然。列表分页展示,页码多时也不会铺满整排。
- 多个同步任务并行互不干扰,随时启动/暂停
- 分页:默认 20 条/页,可选 15 / 20 / 30 / 50 / 100 并跳页
- 页数多时中间以省略号收起,点省略号就地多展开 5 页
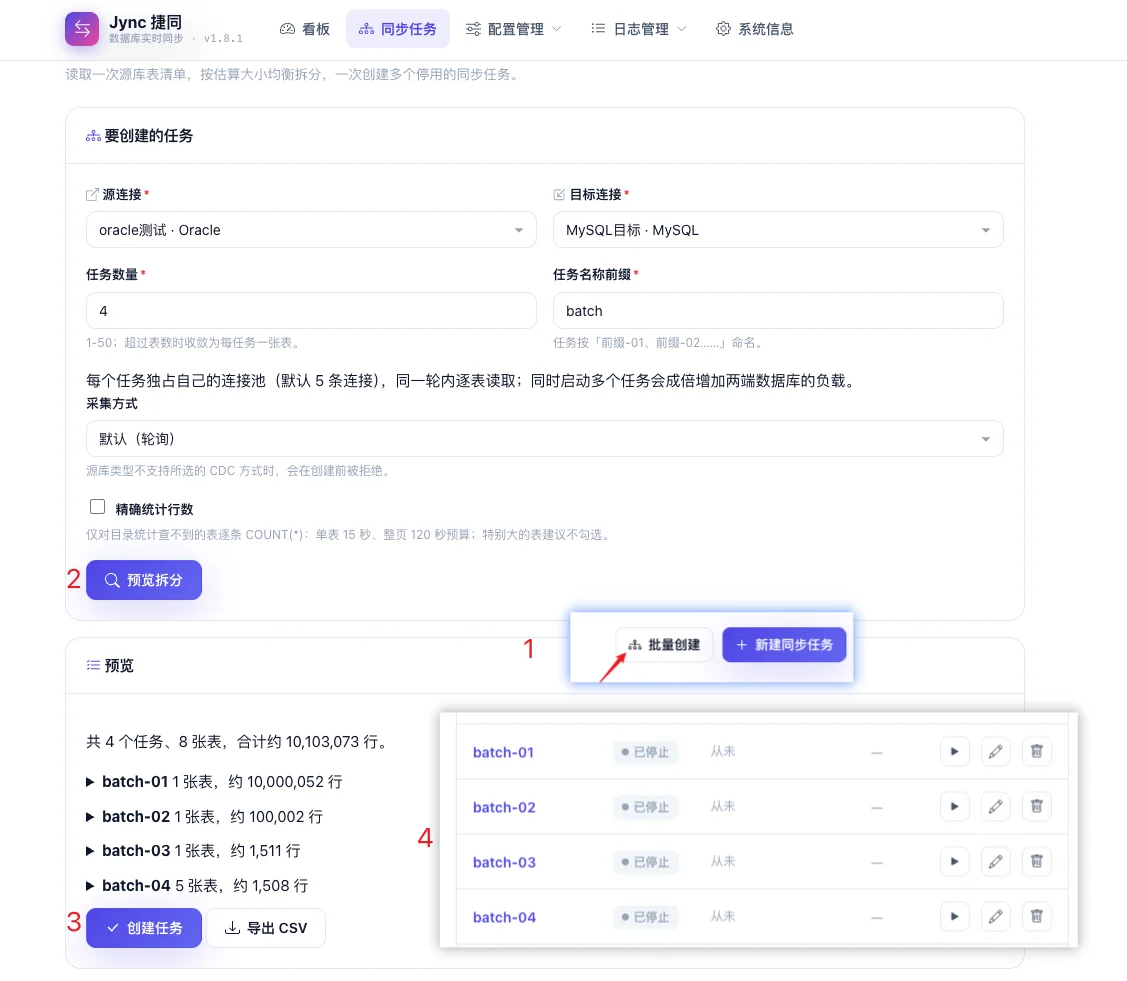
批量创建:按表大小均衡拆成多个任务
表多、表名没有规律时不必手工拆。读一次源库目录统计(不扫表),按估算行数把表均衡分进 N 个任务,预览每箱的表清单后一次建出多个「未启动」的任务。
- 任务数 1–50(默认 8);超过表数时收敛到表数并提示
- LPT 分箱:按行数从大到小,每张表放进当前总重最小的箱;大小未知的表按已知大小的中位数计重
- 需要更准时勾选「精确统计行数」,只对未知表逐条
COUNT(*),单表 15 秒、整页 120 秒预算 - 新任务一律停用,逐表确认后再启动;规划用独立临时池,不影响正在运行的同步
- 预览可导出 CSV(UTF-8 BOM)留档
ETL 任务:按 SQL 取数,批次与单表分区展示
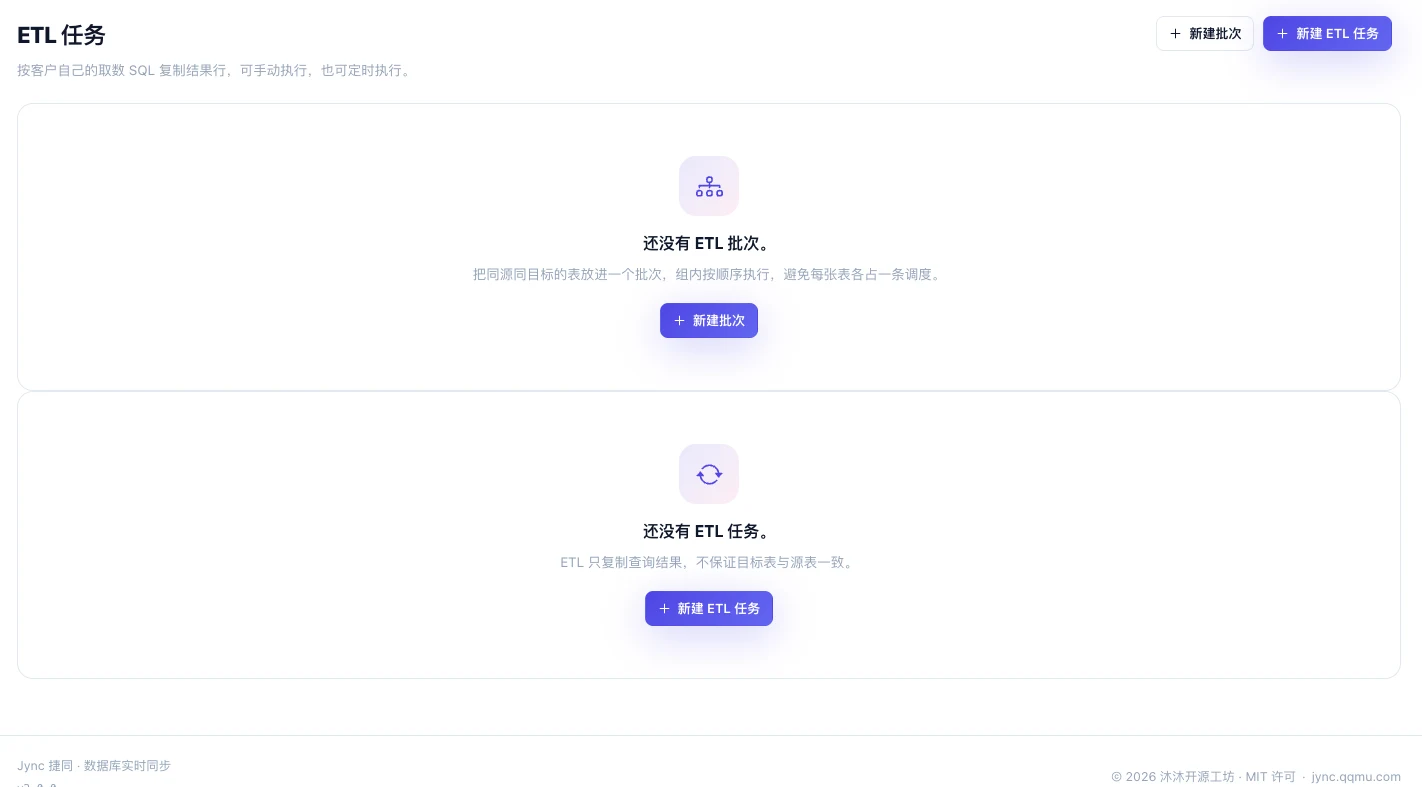
实时同步负责「让两边持续一致」,ETL 负责「按你写的 SQL 取数、写进目标表」。批次任务与单表任务分区展示,每个任务保留自己的取数 SQL、目标表、写模式与最近运行结果。
- 单表任务可独立立即运行、启用 / 停用与编辑
- 批次内的成员显示所属批次,连接与调度由批次统一管理
- 最近运行记录保留成功 / 失败与逐成员汇总
- 支持从源库表清单批量勾选生成默认
select *的成员
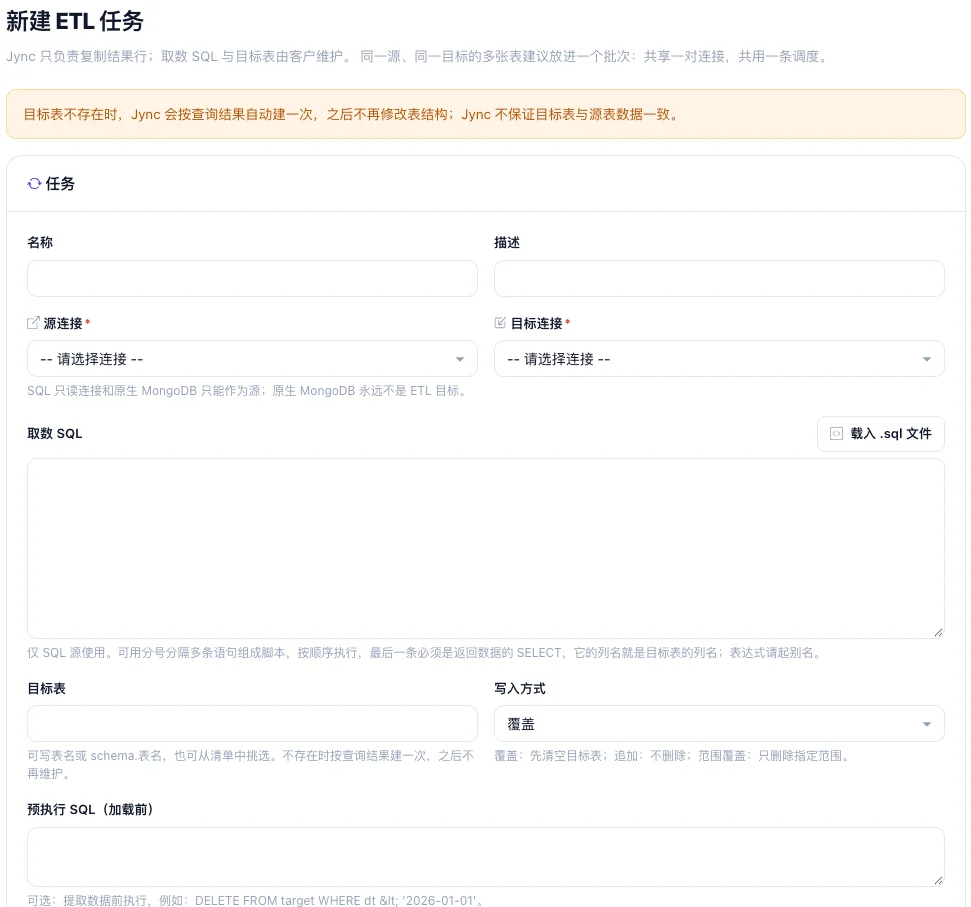
新建 ETL 任务:取数 SQL、目标表与写模式
取数 SQL 可直接编辑,也可从本地载入 .sql 文件;最后一条 SELECT 提供结果行。目标表缺失时按结果列建一次,之后不再自动改结构。
- 写模式:覆盖(清空目标表)/ 追加 / 范围覆盖(按 range condition 删除一段再写)
- resume key 指定唯一且单调的结果列,追加与范围覆盖可断点续跑
- pre-sql / post-sql 在取数前、装载后执行,处理清表与汇总
- 保存前可先跑预检:取数列、目标表、主键与 SQL 逐项检查
- 原生 MongoDB 源用 collection + Extended JSON filter 取数
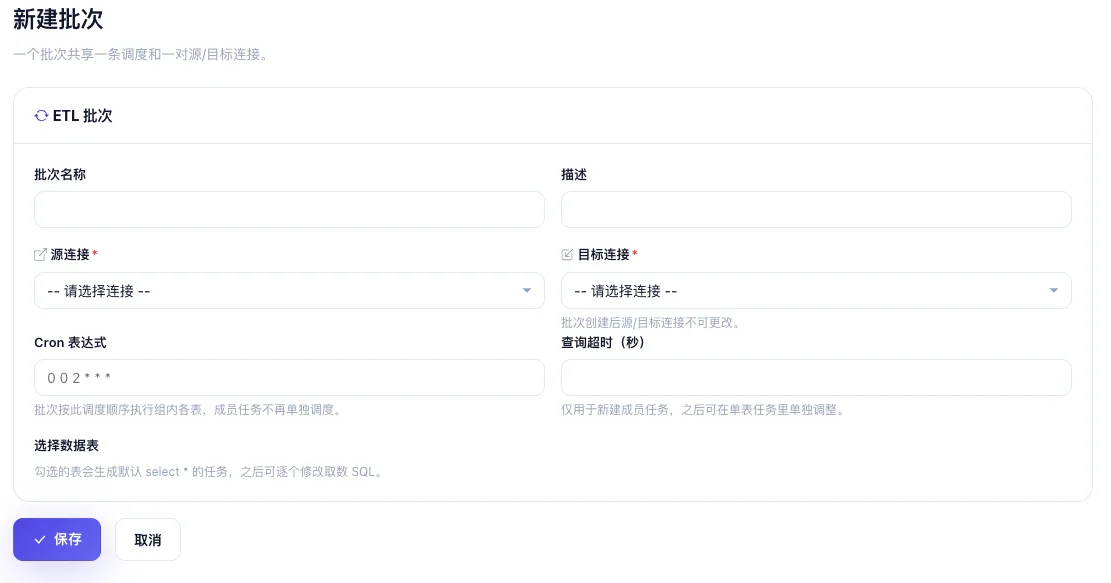
ETL 批次:一组表共享一条调度与一对连接
同源同目标的一组表放进一个批次,运行时只建一对源 / 目标连接,组内按顺序执行 —— 不必为每张表各占一条调度、各做一次连接握手。
- 从表清单勾选建成员:默认
select *、目标表 = 表名、覆盖写模式 - 批次 cron 是组内唯一调度,成员不再单独调度,但仍可「立即运行」
- 单个成员失败不中断后续成员,批次记录成功 / 失败 / 跳过的汇总
- 批次创建后源 / 目标连接锁定;可追加表、移出成员,删除批次级联删除成员与检查点
- 批次内按目标表名去重,避免两个覆盖任务互相覆盖
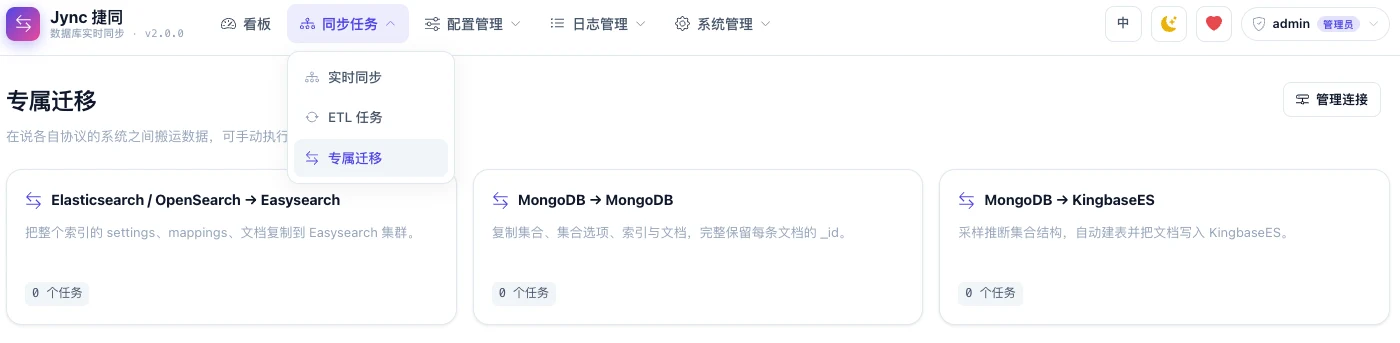
专属迁移:不走 JDBC 的整库复制
实时同步与 ETL 之外的第三条链路,用独立的搜索 / 文档连接做整库复制,不占用 JDBC 连接与同步任务席位。每类迁移都有预检、手动或 cron 运行、运行中可取消,并保留运行历史。
- Elasticsearch / OpenSearch → Easysearch:复制 settings、mappings、别名与文档,保留
_id与 routing,支持覆盖 / 追加 / 冲突即失败 - MongoDB → MongoDB:复制集合选项、索引与文档,完整保留
_id - MongoDB → KingbaseES:采样推断集合结构,自动建表并把文档写入关系库
- 索引 glob 发现、目标命名前缀 / 后缀、写入后计数与抽样校验
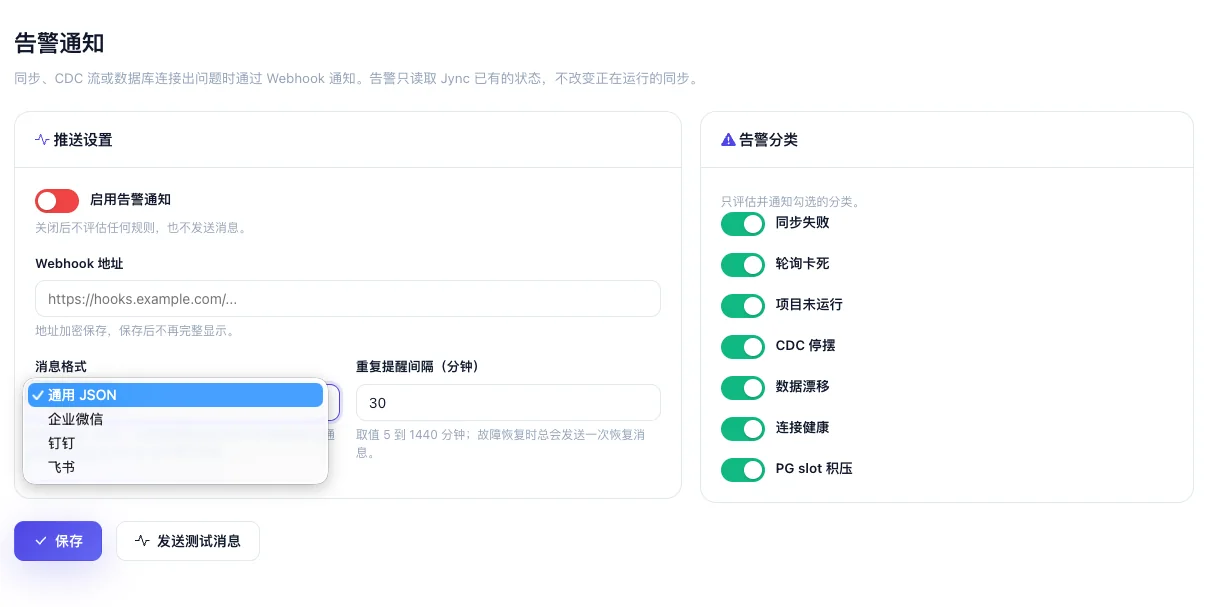
告警通知:故障主动推送,不用盯屏
在「配置管理 → 告警通知」填写 Webhook 地址、选择消息格式与分类,保存后可先发一条测试消息。告警评估只读 Jync 已有的运行状态,不改变同步、CDC 或 ETL 任务的行为。
- 七类事件:同步失败、轮询卡死、项目未运行、CDC 停摆、数据漂移、连接健康、PG slot 积压
- 消息格式:通用 JSON / 钉钉 / 企业微信 / 飞书
- 重复提醒间隔(冷却)可调,故障恢复时发送恢复通知
- Webhook 地址 AES-256 加密存储;关闭告警后不评估规则、不发送消息
同步任务详情:逐表勾选与游标策略可视化
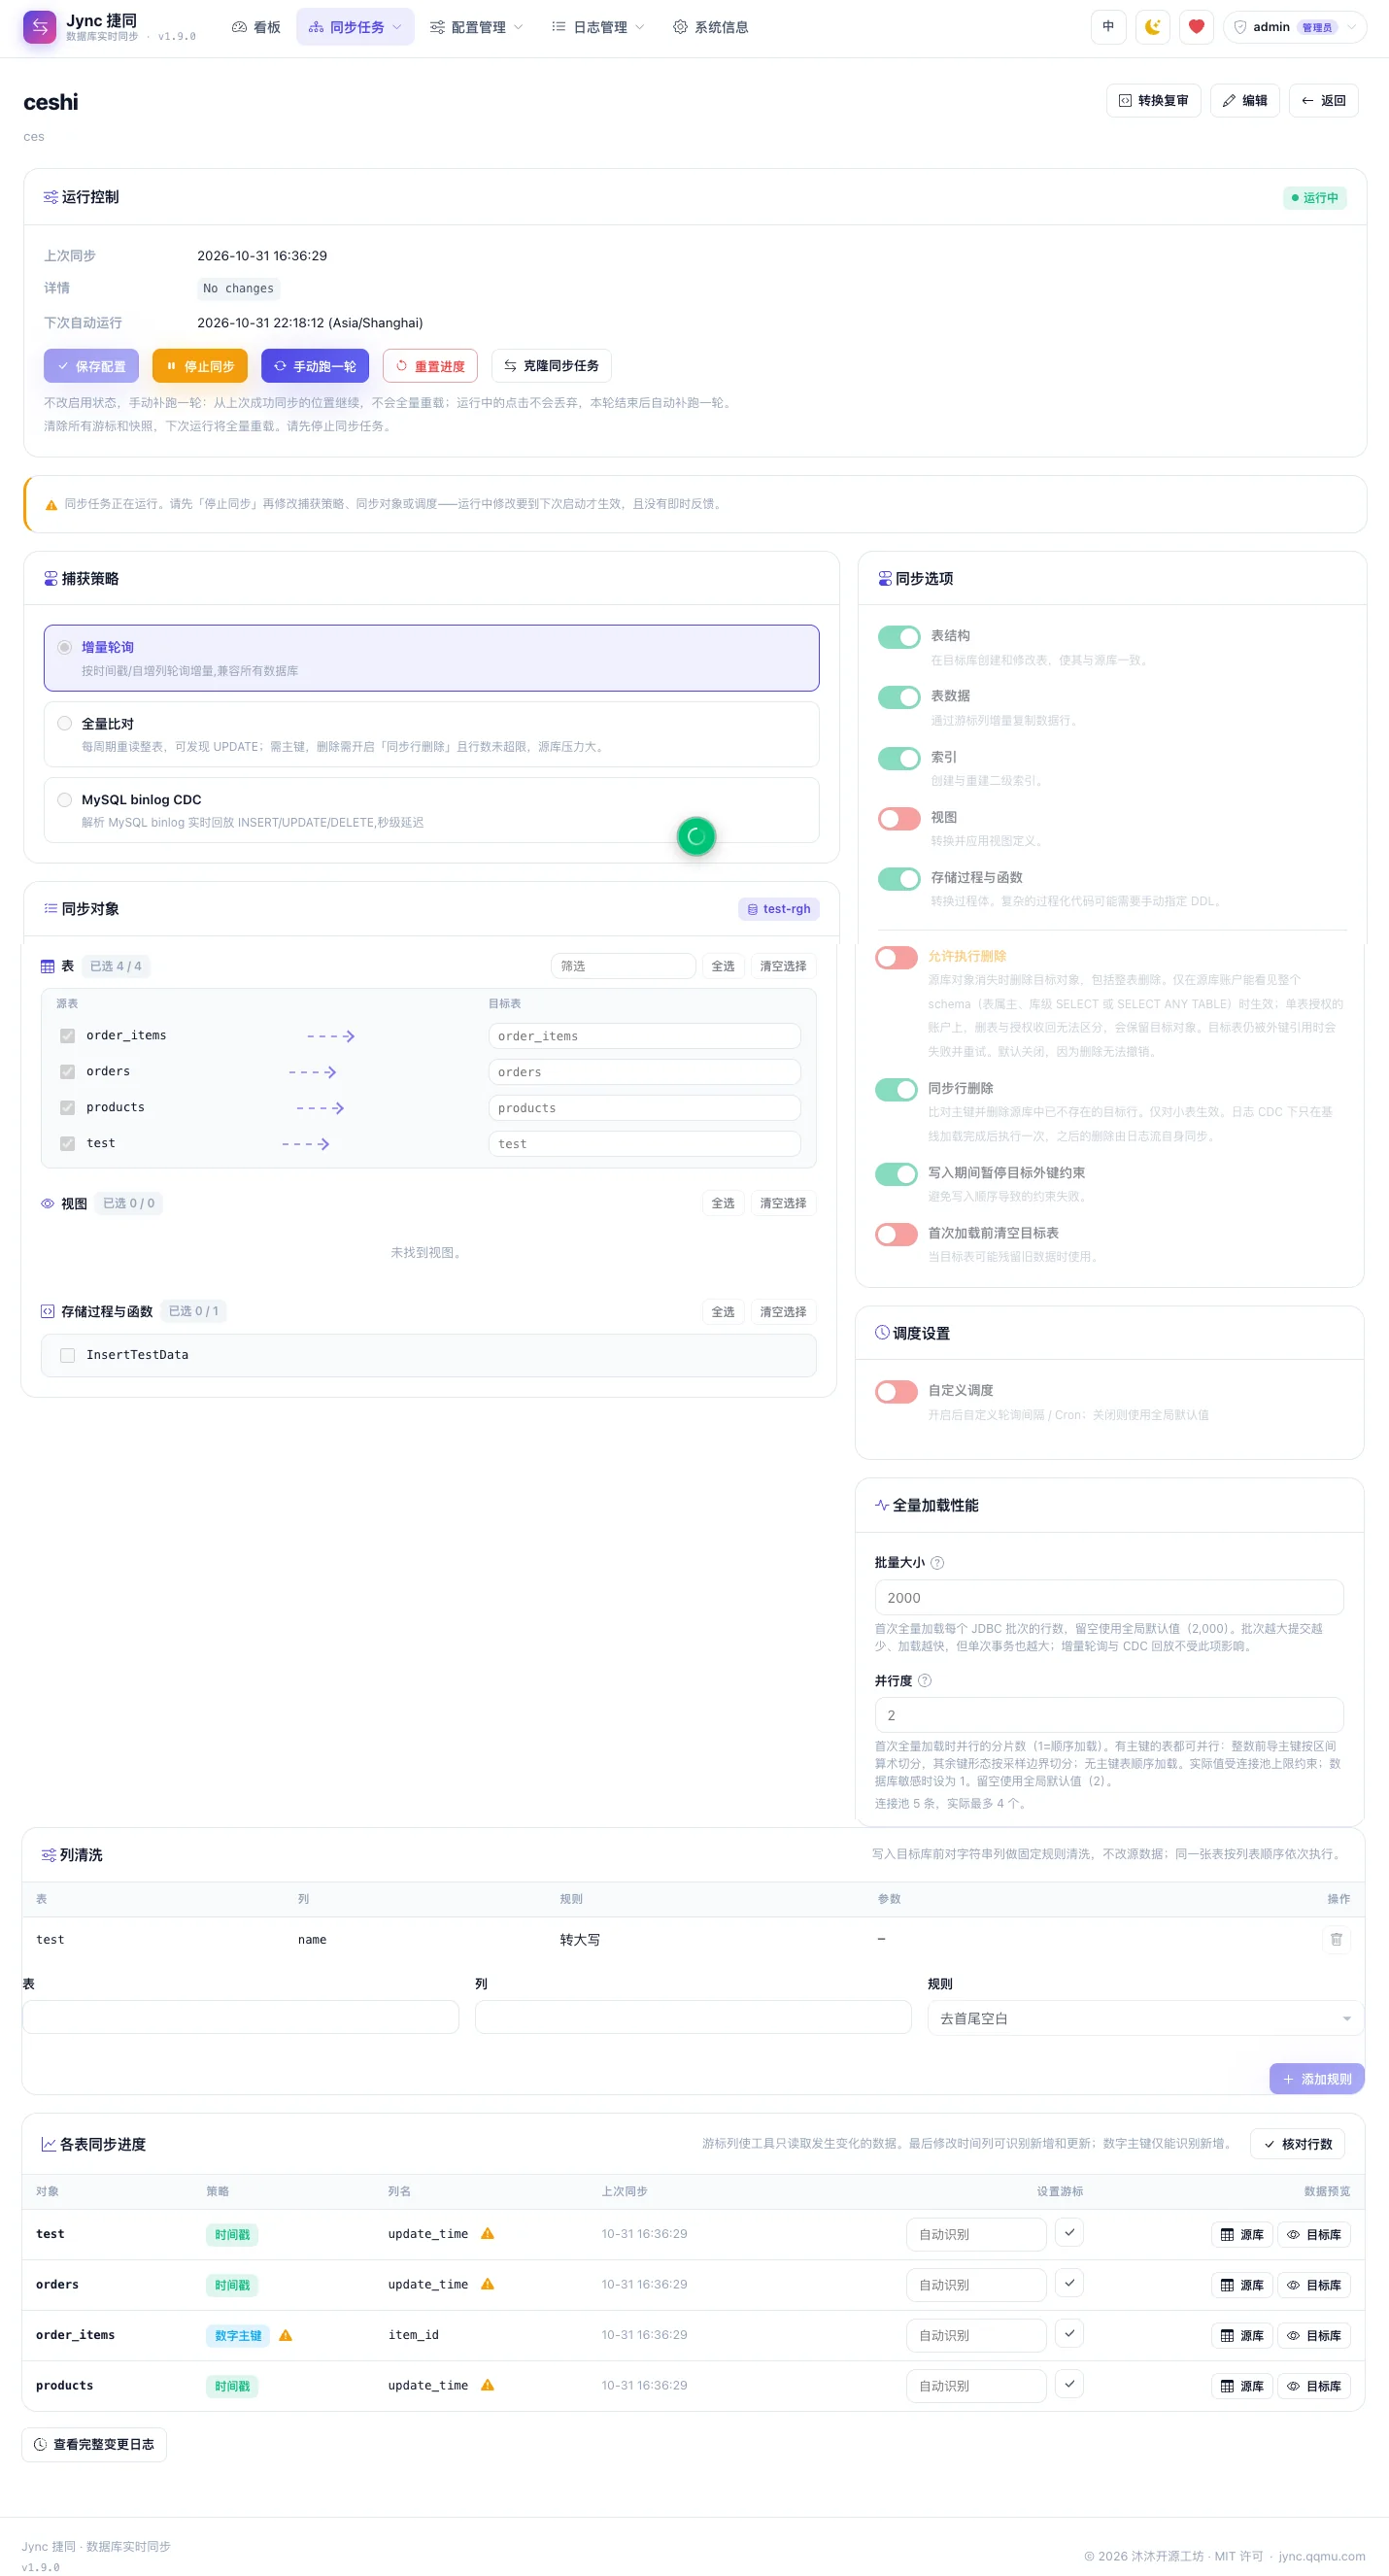
表 / 视图 / 存储过程分组勾选,支持搜索与批量操作;每张表的增量检测策略直接标注,游标列可手动指定。
TIMESTAMP策略:可检测更新IDENTITY/NONE策略显著提示 —— 意味着更新可能同步不到FULL_COMPARE策略:需主键的周期性整表比对;超出上限或当前间隔下负担过重时,页面会提示并给出建议间隔- 捕获策略三卡片切换(轮询 / 全量比对 / 日志 CDC),CDC 仅在就绪探测全部通过时标注「推荐」
- 「立即同步」运行中再点不会丢:本轮结束后自动补跑一轮,连点多次只补一轮
- 只读账号下写入操作不可见
日志 CDC:亚秒~秒级延迟,变更全捕获
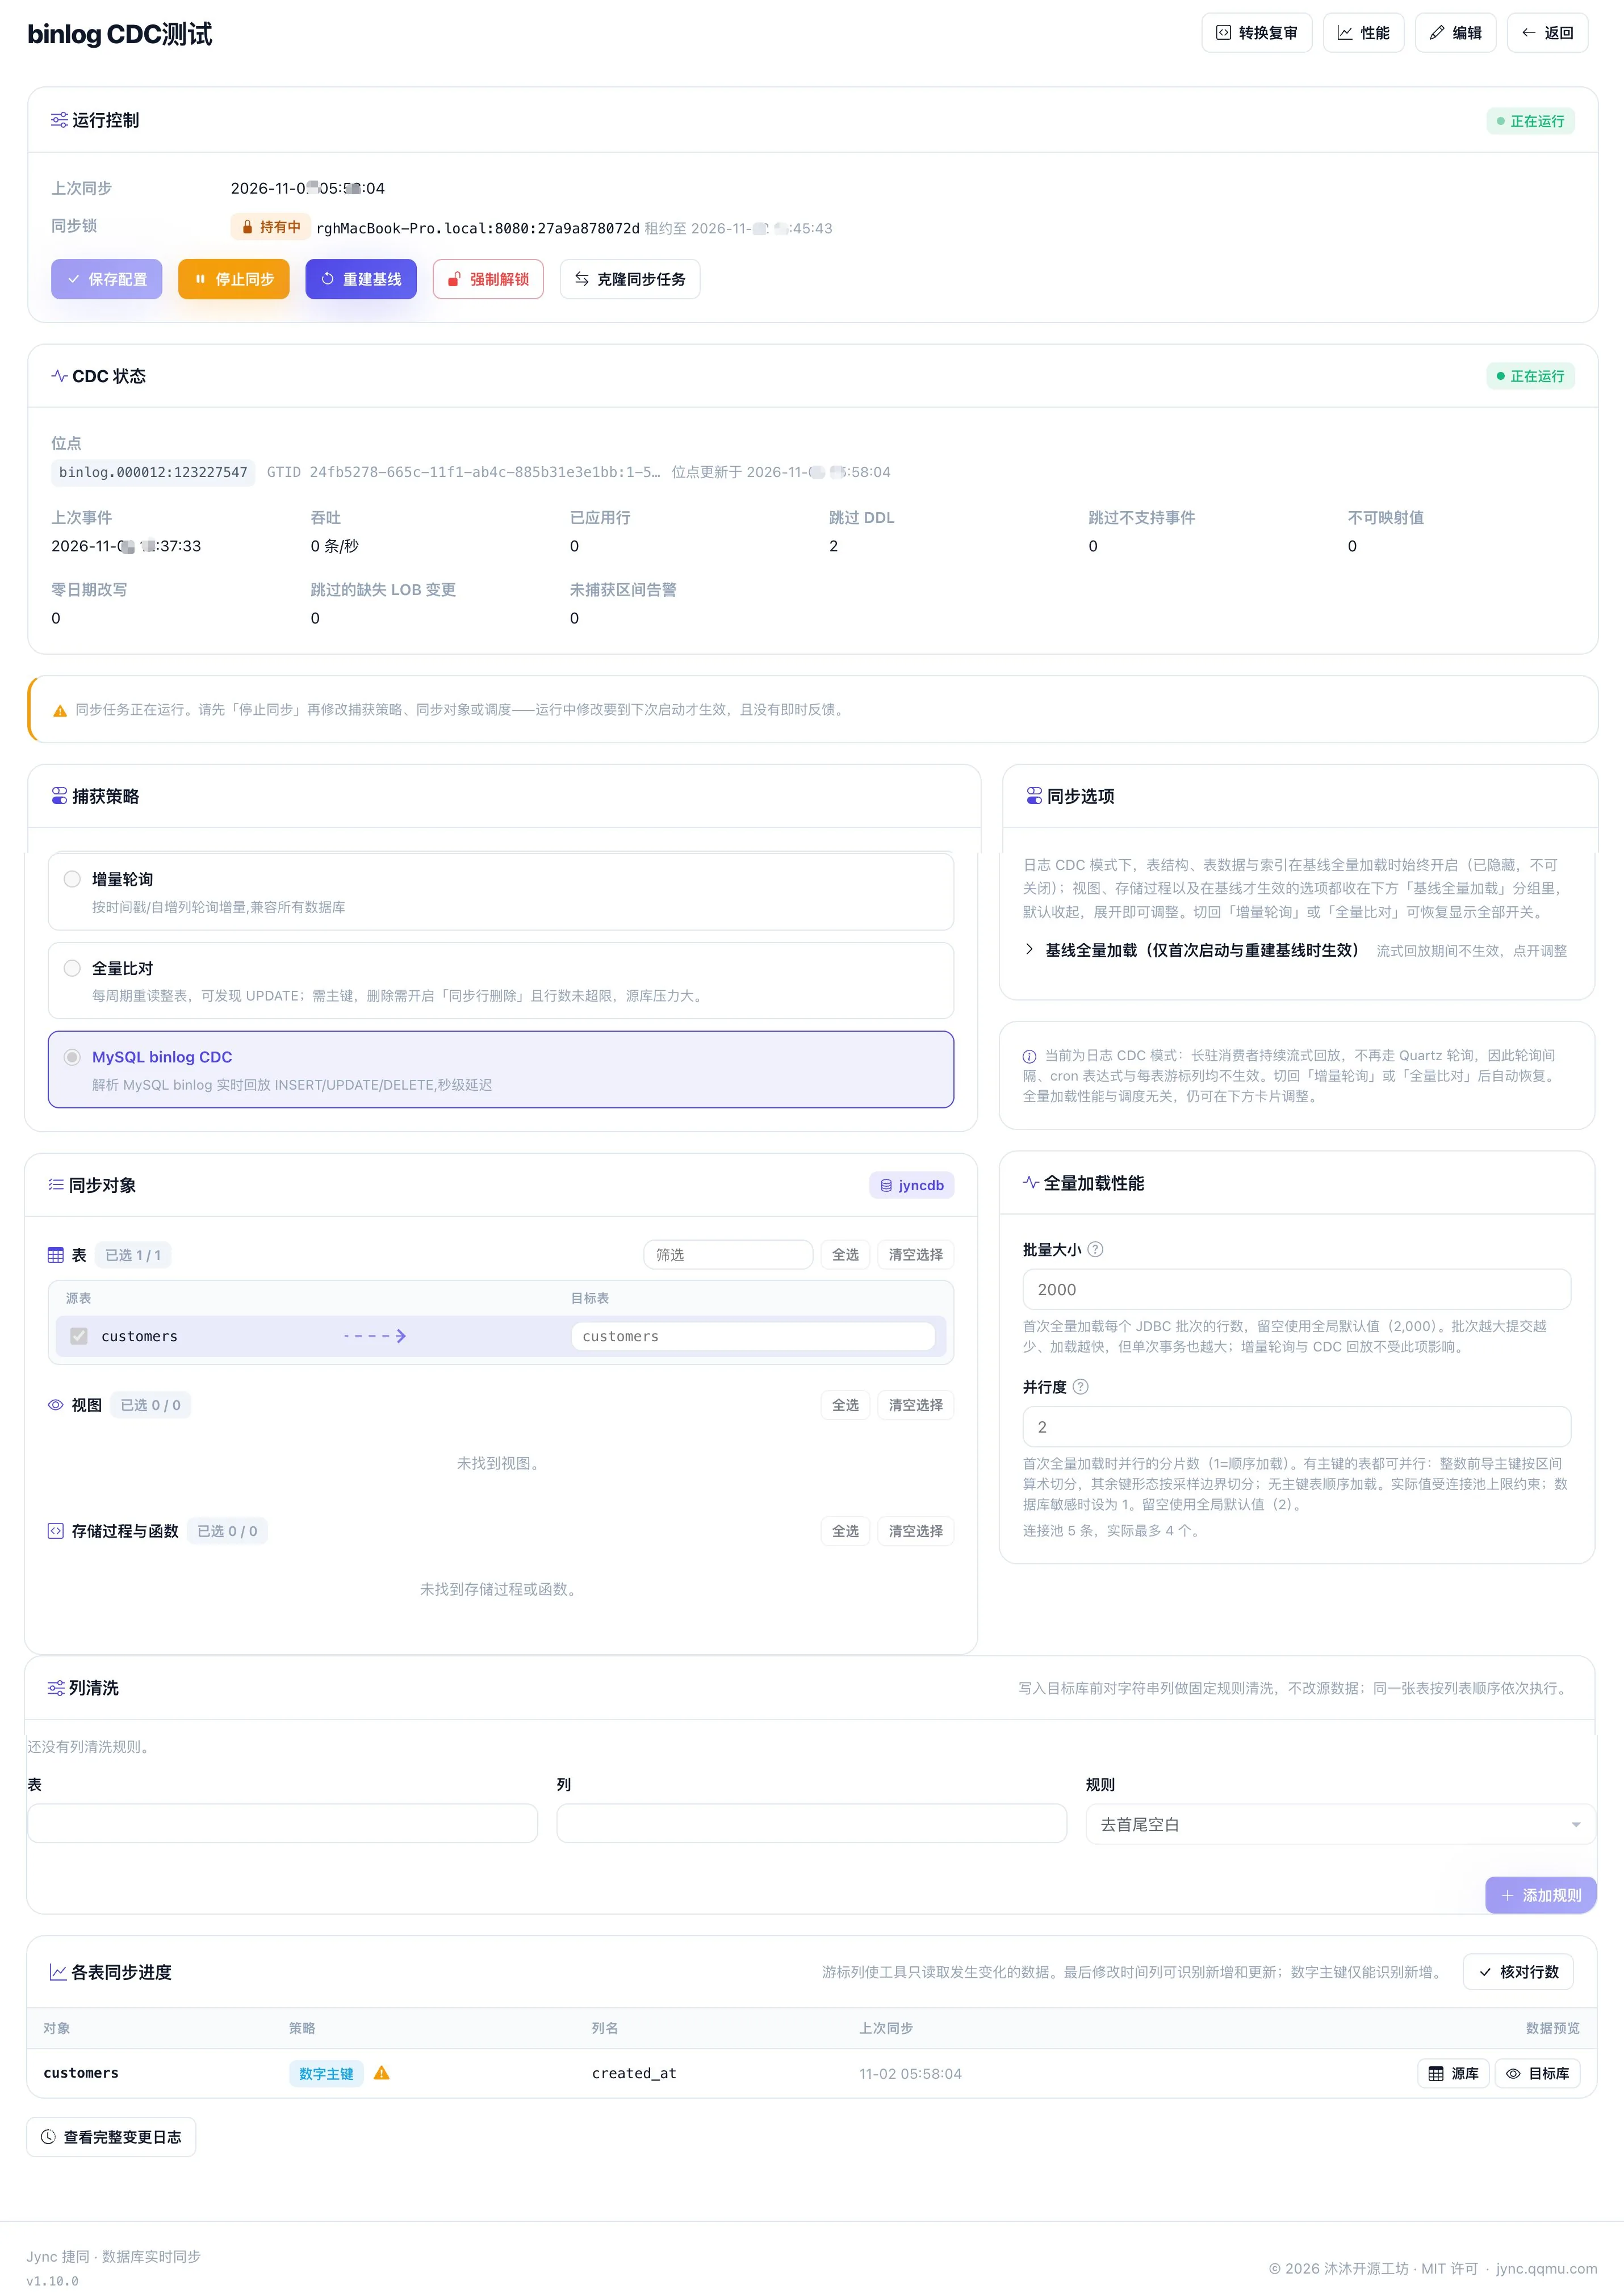
MySQL 兼容家族、Oracle、达梦、PostgreSQL 方言家族、SQL Server 与崖山源可按同步任务从轮询切换到日志 CDC —— 直接解析数据库自身日志流,INSERT / UPDATE / DELETE 全捕获,严格按日志顺序回放。繁忙时捞到数据立即开下一轮(0 等待),只有真空闲才休眠轮询,延迟不再被固定 sleep 拖慢。
- 切换前逐项就绪探测:日志开启、格式、权限、保留期,不满足项直接给出原因
- 状态面板:当前位点、上次事件时刻、吞吐、已应用行数、跳过 DDL / 不支持事件 / 不可映射值、零日期改写与 LOB 跳过计数及最近错误
- at-least-once + 幂等 upsert:先提交数据再推进位点,崩溃重启不丢数据
- 多实例租约互斥,持锁节点宕机后其余节点 ≤ 60s 自动接管
- 不建触发器、不写源库 —— 对日志全程只读
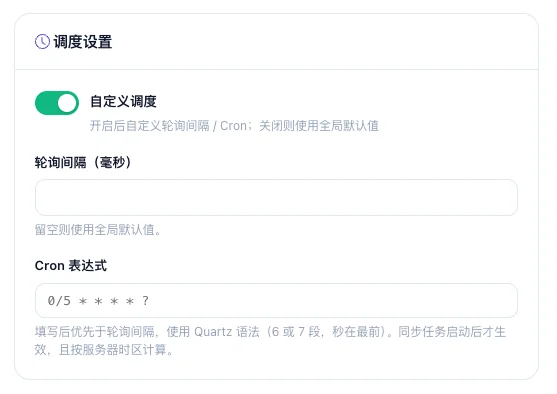
调度设置:轮询间隔或 Cron,按同步任务单独覆盖
轮询与全量比对任务默认跟随全局 2 秒间隔。开启「自定义调度」后,可为该同步任务单独填写轮询间隔(毫秒)或 Quartz Cron 表达式(6 / 7 段,秒在最前);Cron 优先于轮询,留空则回落到全局默认值。
- 轮询间隔适合持续追增量,Cron 适合每天凌晨定时批量跑
- Cron 按服务器时区计算,同步任务启动后生效
- 日志 CDC 同步任务由常驻消费线程流式回放,调度卡片自动隐藏并说明原因
- 批次与并行度不属于调度,独立放在「全量加载性能」卡片,关闭自定义调度也不会被清空
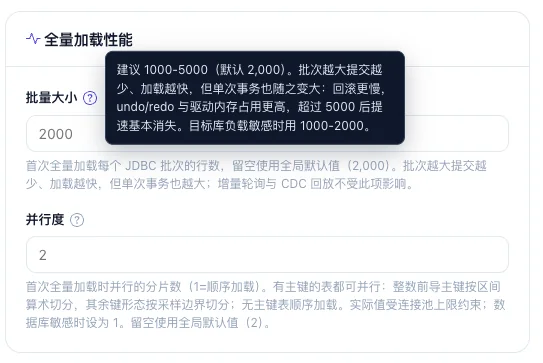
全量加载性能:批次与并行度,按库承受能力调
首次全量和 CDC 基线重建共用这些参数:批量大小控制每个 JDBC 批次的行数,默认 2000(1–20000);并行度控制分片 worker 数,默认 2,最高 8;分块大小控制单块行数,填小于等于 0 表示关闭分块。
- 批次越大提交越少、加载越快,但单次事务更大,回滚与锁持有时间更长
- 每个 worker 同时占用 1 条源连接和 1 条目标连接,实际并行度受连接池上限二次限制
- 有主键的表都可并行:整数前导键按区间算术切分,其余键形态按采样边界切分;无主键表顺序加载
- 只影响首次全量与重建基线,增量轮询和 CDC 回放仍使用全局批次,不会被这里放大
- 数据库压力敏感时把并行度设为 1,并适当调小批次
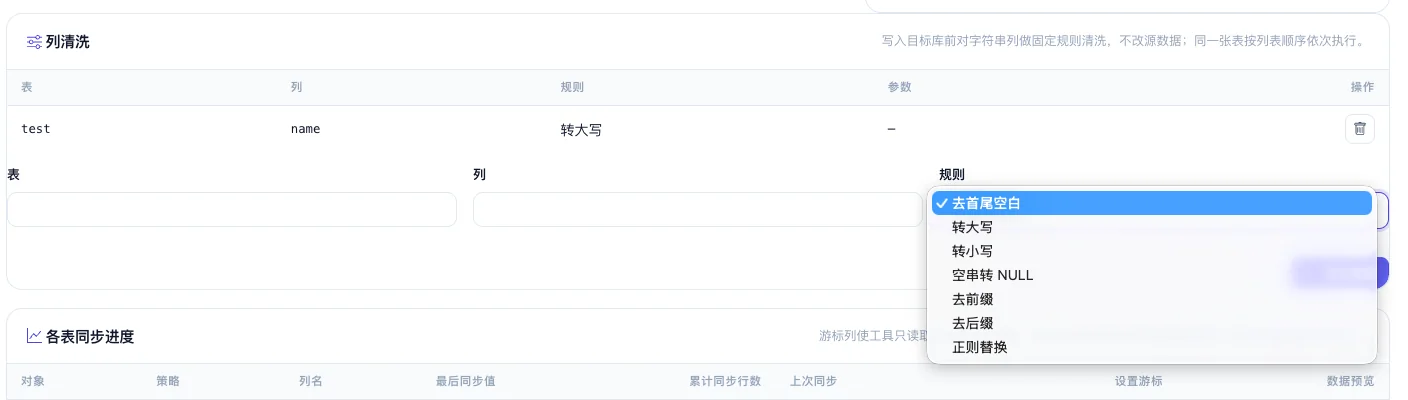
列清洗:写入前统一字符串,不动源库
按「表 + 列」添加规则,在写入目标库前于内存中依次执行,源库数据保持不变。规则同样作用于全量、增量与 CDC 回放;主键列参与匹配与删除时,也使用清洗后的值。
- 七种基础规则:去首尾空白、转大写、转小写、空串转 NULL、去前缀、去后缀、正则替换
- 六种脱敏规则:手机号、身份证、银行卡、姓名、邮箱的格式保留掩码,以及带可选盐的 SHA-256 哈希
- 只处理字符串列,数字和日期原样通过,不做隐式类型转换
- 正则替换支持
$1分组引用;表达式与替换串在保存时校验 - 规则按列表顺序执行,可逐条添加和删除;运行中的同步任务需先停止再修改
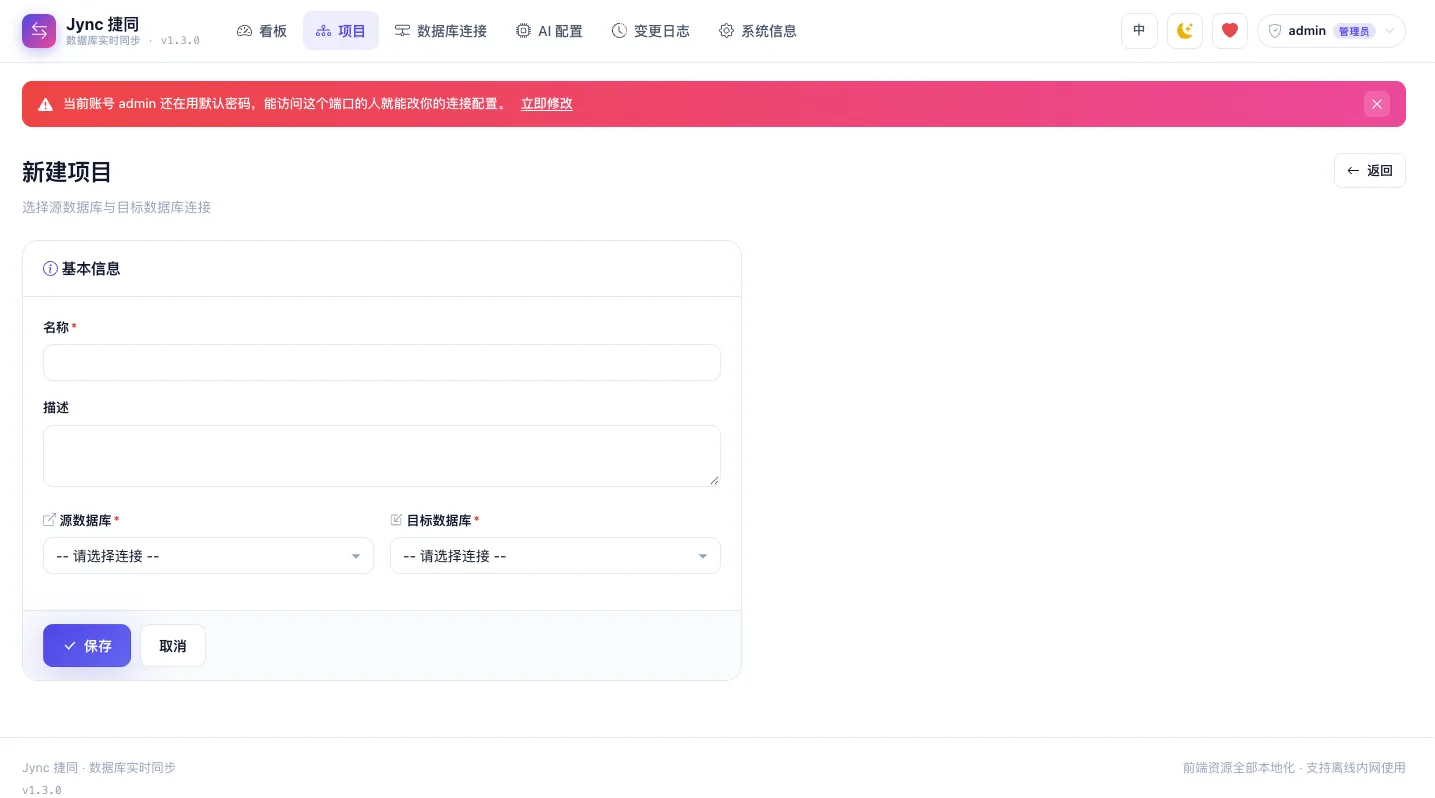
新建同步任务:源与目标各选一条连接
一个同步任务就是一条「源库 → 目标库」链路。新建时源、目标下拉各自只列出对应用途的连接,不会把只该写入的库错选成源。
- 源 / 目标下拉按连接用途过滤,选不错方向
- 建好后进同步任务详情勾选要同步的表 / 视图 / 存储过程
- 权限按 HTTP 方法判定:新建等写操作一律要求管理员,访客界面上看不到入口
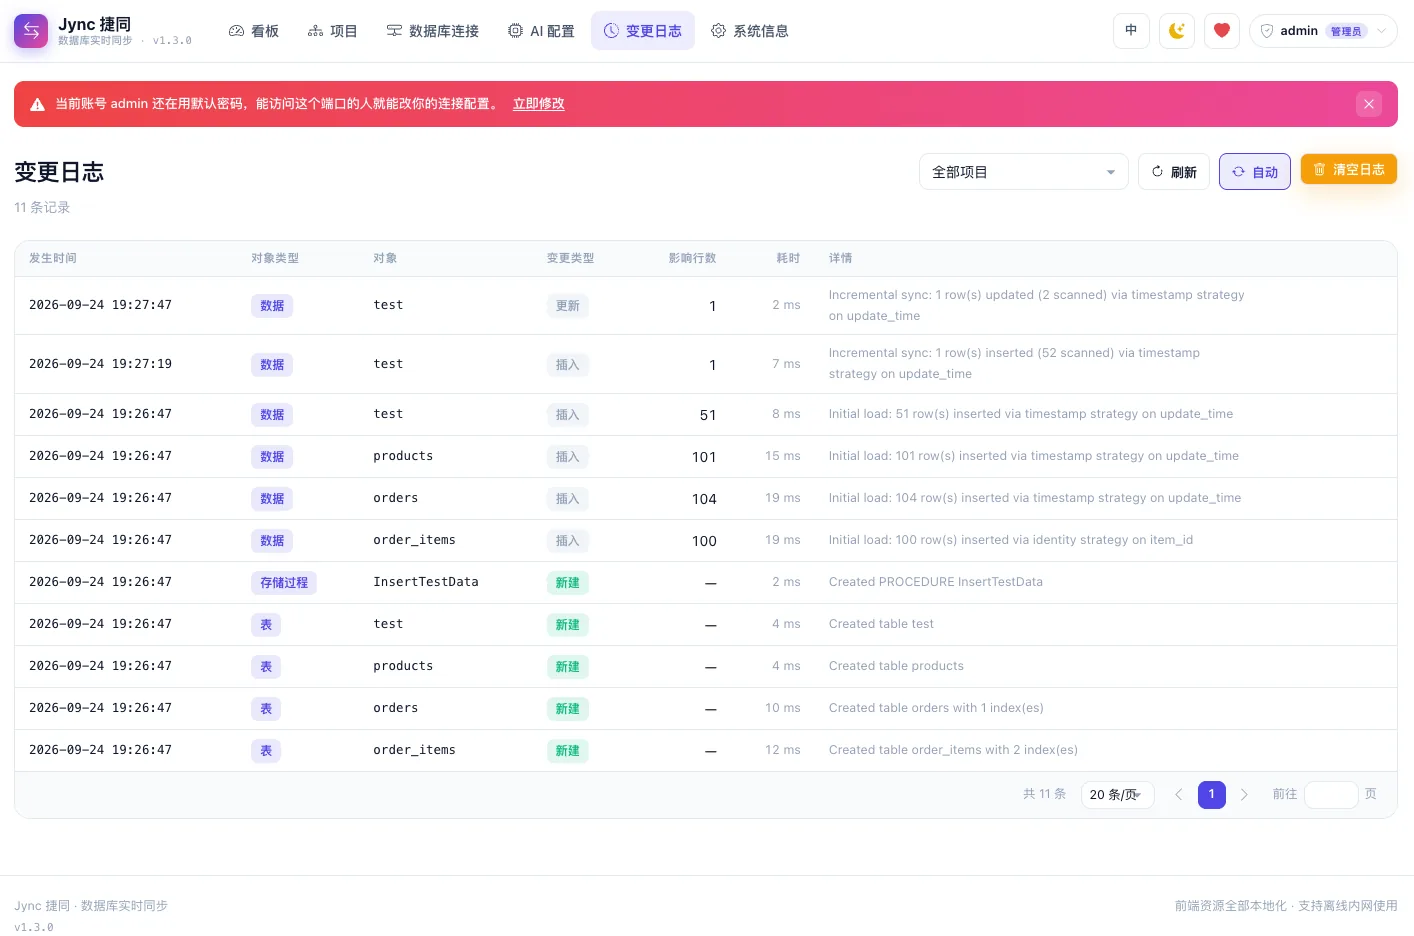
变更日志:每一次变更都可追溯
对象名、变更类型、影响行数、耗时与完整错误详情。问题排查不靠猜,全在日志里。
- 每次同步的明细记录,错误详情完整展示
- 支持按时间范围筛选,与同步任务列表同一套分页
- 第 2 页起自动刷新禁用 —— 日志按时间倒序,刷新会让正在读的行一直换位置
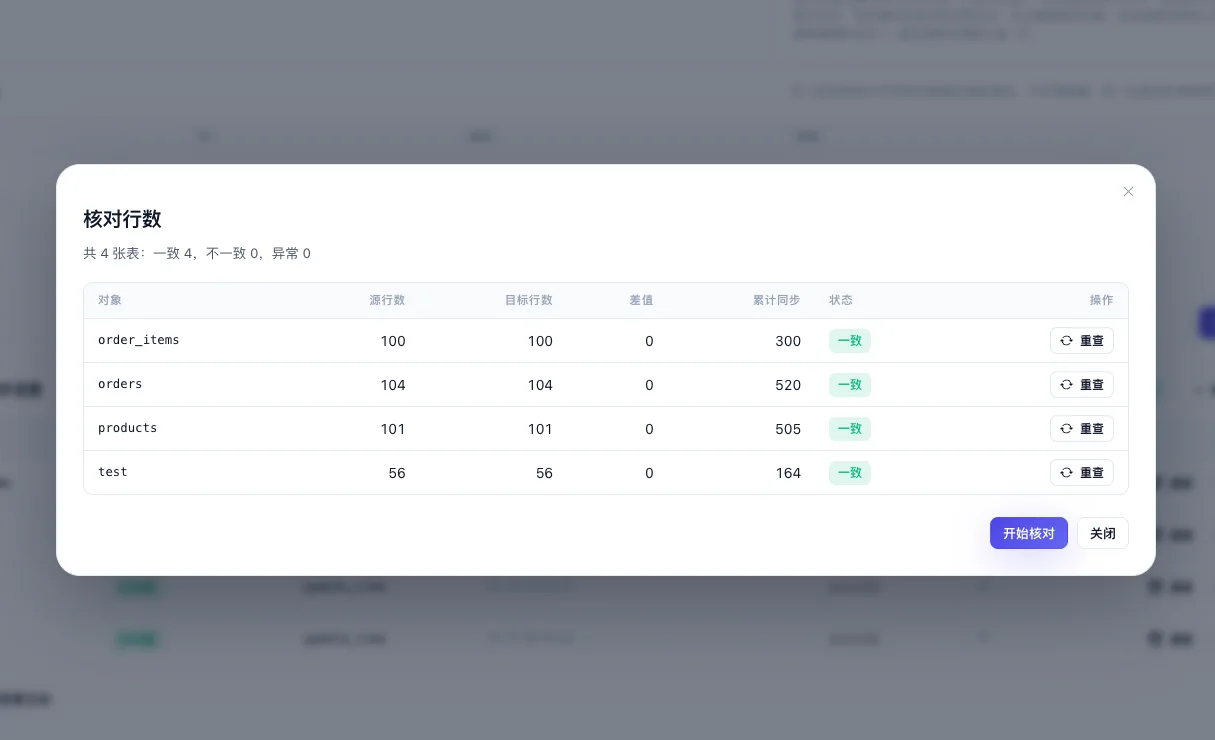
核对行数:源 / 目标 COUNT 按需对比
在「各表同步进度」卡片点「核对行数」,确认后逐表串行执行。弹窗列出对象、源行数、目标行数、差值、累计同步与状态;每行可单独重查,表头徽标汇总不一致与异常数量。
- 只在确认后查询,页面加载时零请求
- 单侧 15 秒查询超时,缺表 / 超时 / 其他异常分别标记
- 源 / 目标独立计数,一侧失败不掩盖另一侧结果
- 仅管理员可用,访客看不到入口
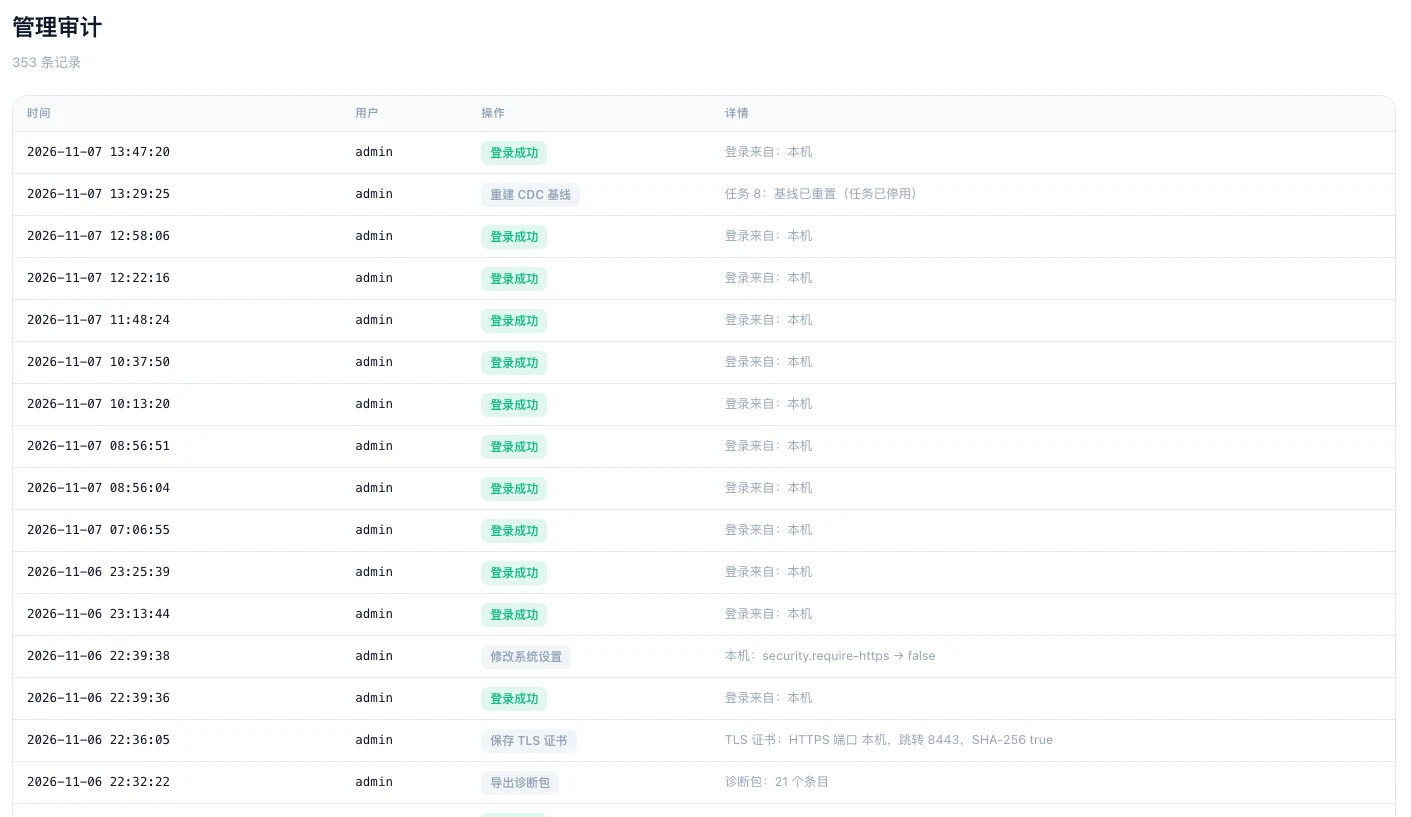
外部认证:门户账号直接登录,三种方式互斥
「配置管理 → 外部认证」把企业现有的身份体系接进来:账号密码由 Jync 服务端 POST 到 OA 登录接口校验,网关头由网关传递已认证用户,票据模式由登录中心签发一次性 ticket。同一时刻只生效一种方式。
- 账号密码模式支持表单 / JSON 请求、字段名映射、
data.user点路径与成功标识 - 网关头只采信可信代理(默认仅回环)转发的身份头,可选共享密钥
- 票据入口按客户端 IP 限流,校验通过才建立会话,票据不写审计、不在页面回显
- 外部用户只保留会话,不写入本地用户表;管理员列表命中即为管理员
- 完成配置后可关闭本地登录;外部认证故障时用
JYN_RESET_LOGIN=true应急恢复
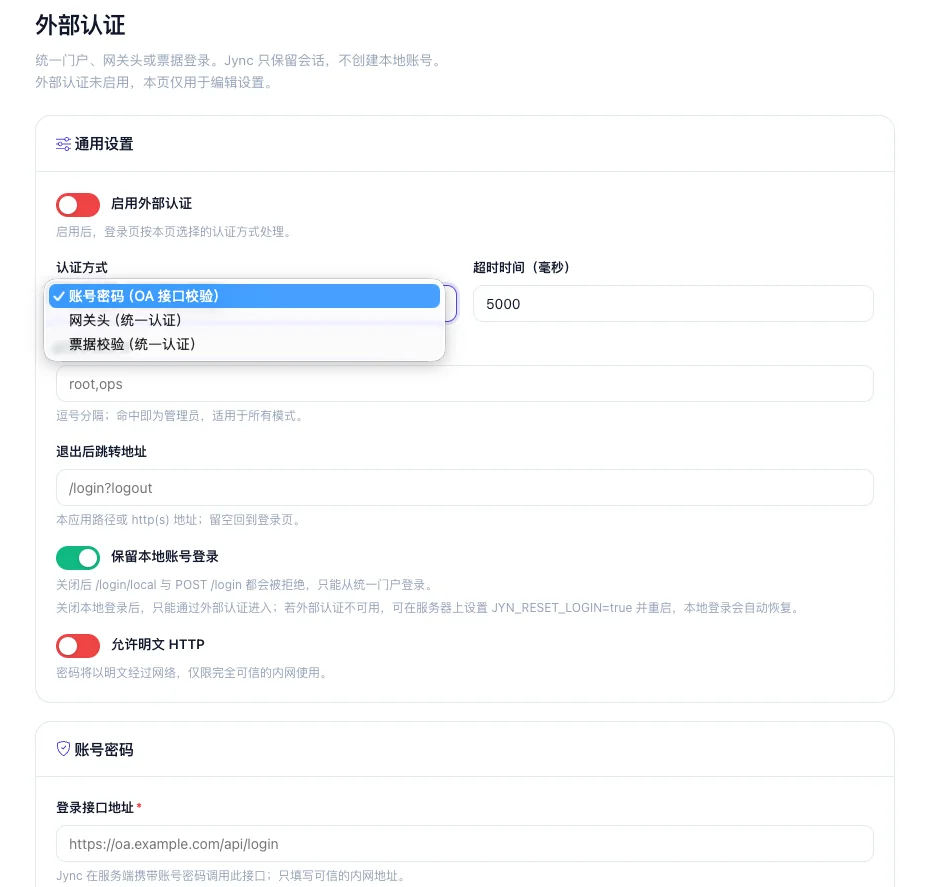
系统日志:按文件、级别与关键字定位问题
「日志管理 → 系统日志」直接读取日志目录里由滚动策略生成的文件,按文件、级别与关键字过滤,命中内容高亮显示。排查启动失败、连接异常或调度问题时,不用再登录服务器翻日志。
- 级别筛选:DEBUG / INFO / WARN / ERROR / 全部,关键字不区分大小写
- 滚动归档按 gzip 自动解压读取;普通文件从尾部、归档从头部扫描
- 单次最多扫描 16 MB,返回最近 1000 条匹配行,并提示是否截断
- 文件名白名单 + 真实路径校验,拒绝
../与符号链接逃逸 - 登录与敏感操作另记审计日志,与变更日志、系统日志各归其位
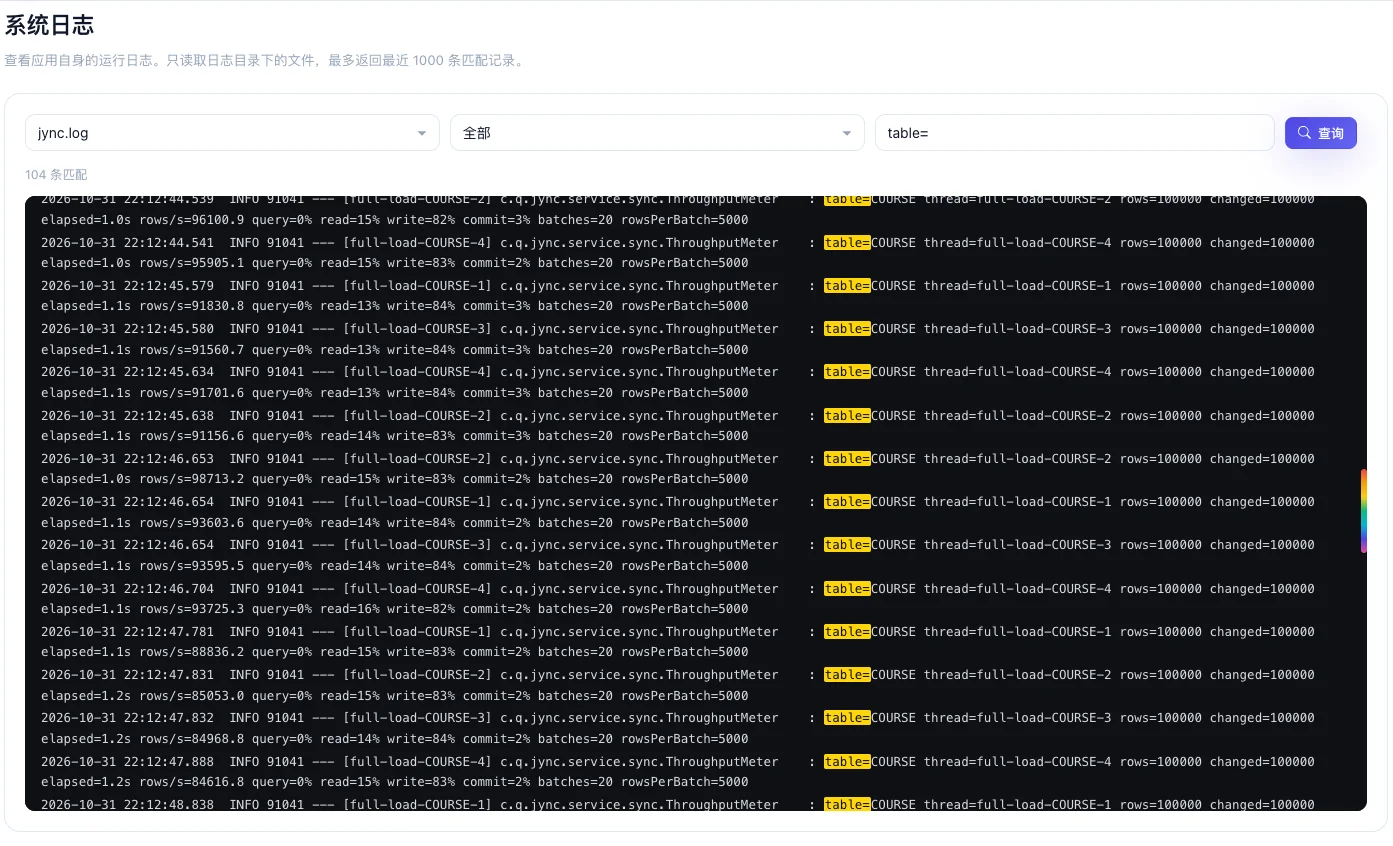
系统配置:证书、强制 HTTPS 与配置包都在界面里
「系统管理 → 系统配置」把过去必须改配置文件或数据库的事情搬进页面:上传证书让 Jync 自己提供 HTTPS,开关强制 HTTPS,导出 / 导入整套配置,还能先测一次候选元数据库。
- TLS 证书支持 PKCS#12 / JKS 密钥库与 PEM 证书链 + 私钥,保存后重启生效
- 证书与加密后的口令存在数据目录
./data/tls,不进元数据库、不进配置包 - 页面把「已保存 / 已生效 / 等待重启 / 移除待重启」分开显示,证书到期前 30 天提示
- 配置包
.jync用 AES-256-GCM + PBKDF2 口令加密,可整体迁移到另一个元数据库 - 元数据库连接测试器生成一段 POSIX 安全引用的
SPRING_DATASOURCE_*环境变量块
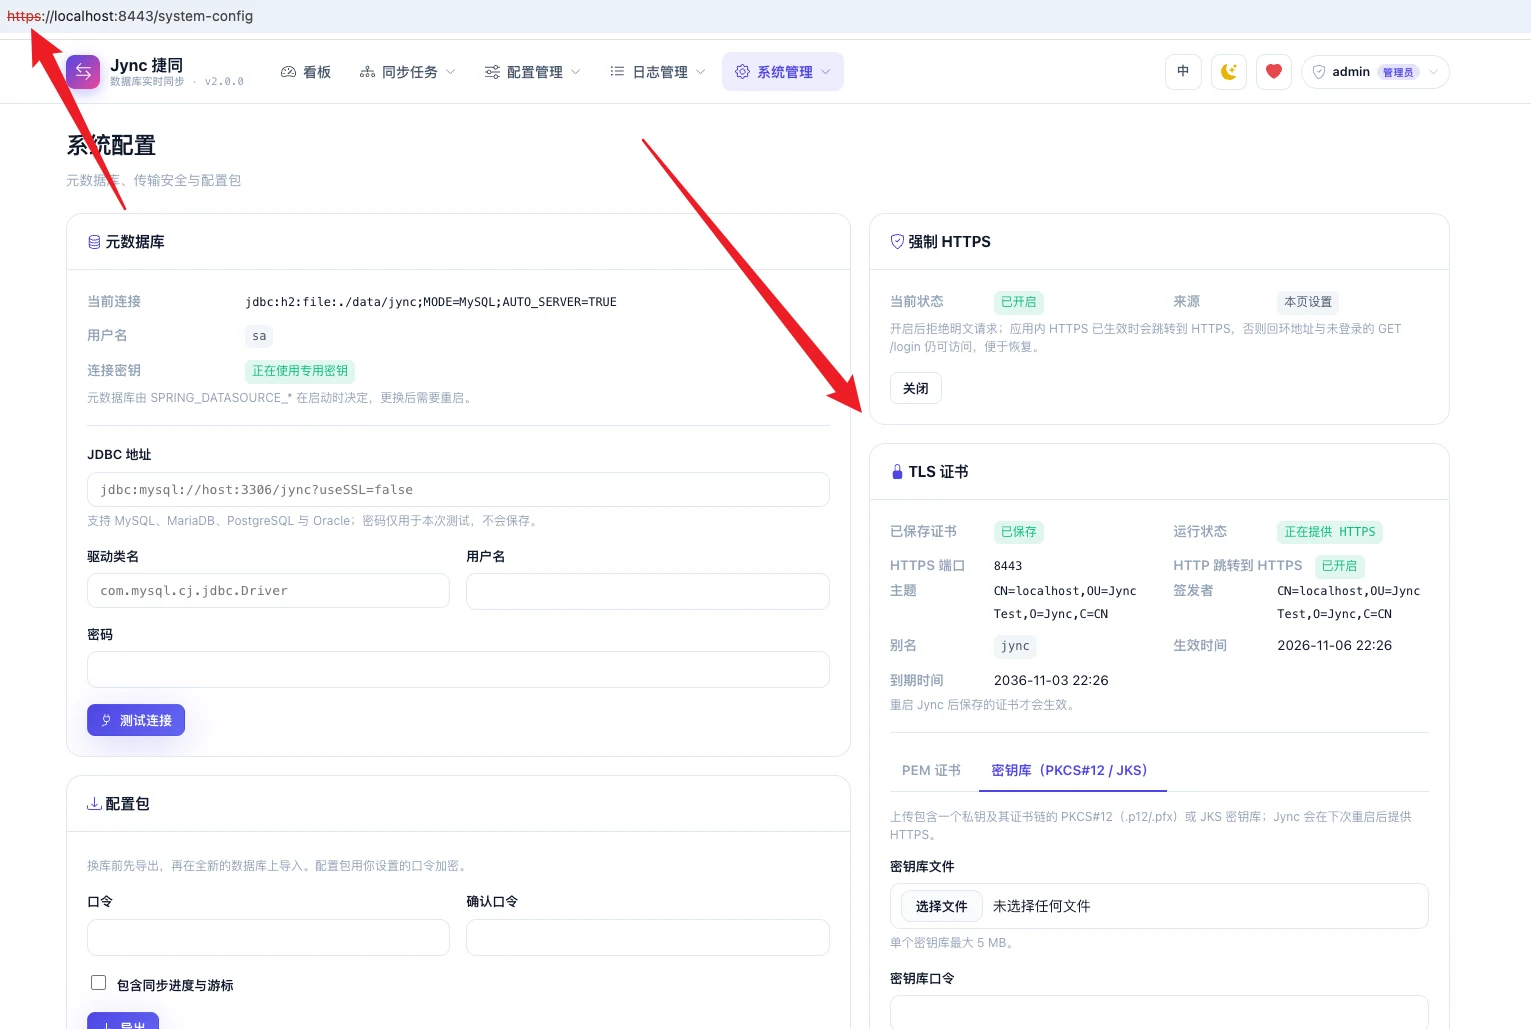
管理审计:谁在什么时候改了什么
登录、配置变更、任务启停、TLS 与配置包操作都会留下一条审计记录:时间、用户、操作与详情。只读、仅管理员可见,用来回答「这项配置是谁改的」,与变更日志、系统日志各归其位。
- 登录成功 / 失败、注销与密码修改
- 连接、同步任务、ETL 与专属迁移的保存、启停与删除
- 系统设置、强制 HTTPS、TLS 证书与配置包导入 / 导出
- 详情里的 URL 一律脱敏,口令与
enc:密文不入审计
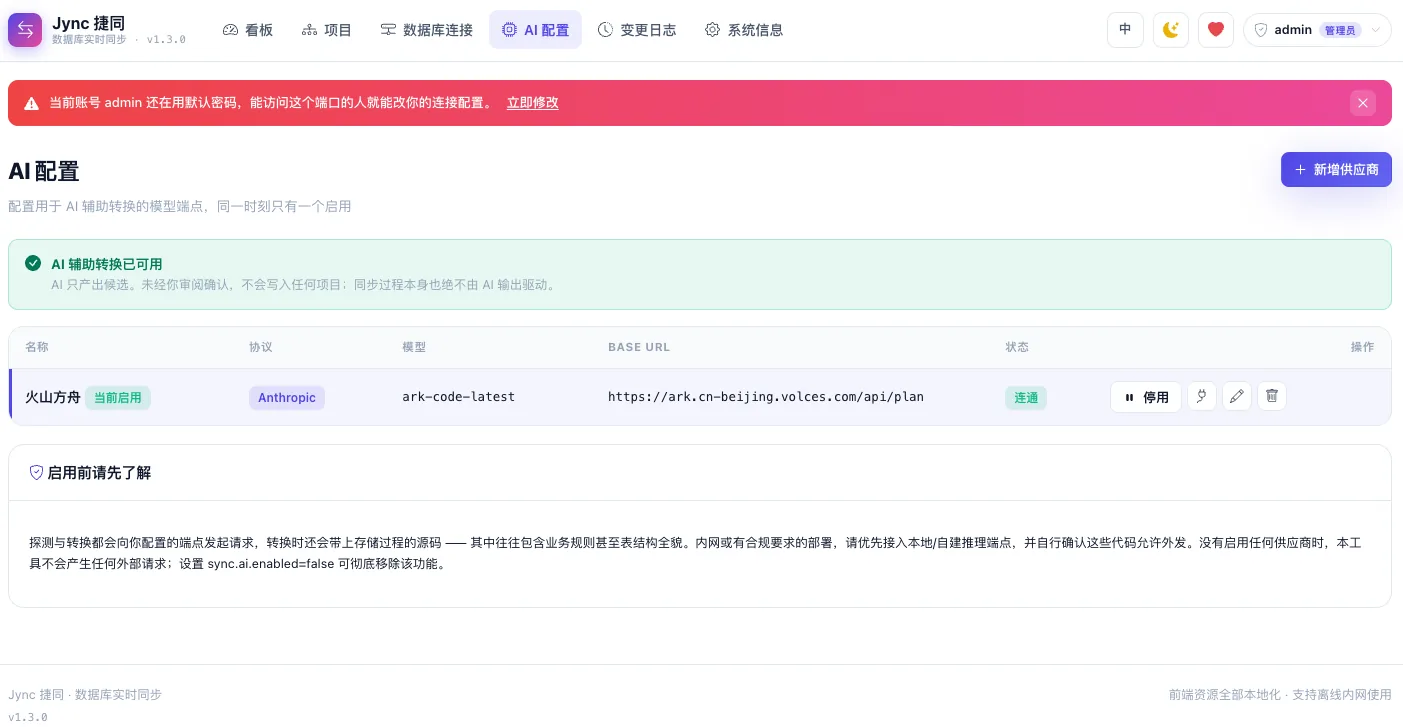
AI 配置:多供应商共存,同一时刻只启用一个
存储过程里的不兼容语法,靠文本替换只能走到一定程度。AI 配置 提供另一条路:让模型起草一份候选,由你审阅后落库。
- 支持
OpenAI 兼容、Anthropic与Ollama(本地)三种选择 - 深度思考可开关(跟随默认 / 关闭 / 低 / 高)。关掉不只是快:思考 token 会计入输出预算,小
max_tokens下正文甚至会被思考挤空,表现成「一直转圈然后报模型返回空内容」 - 保存前先探测端点 —— 发一次真实请求,而非 TCP 探活
- 密钥与数据库密码同样 AES-256 加密存储
- AI 只产出候选,永不直接参与同步
sync.ai.enabled=false可彻底下线该功能
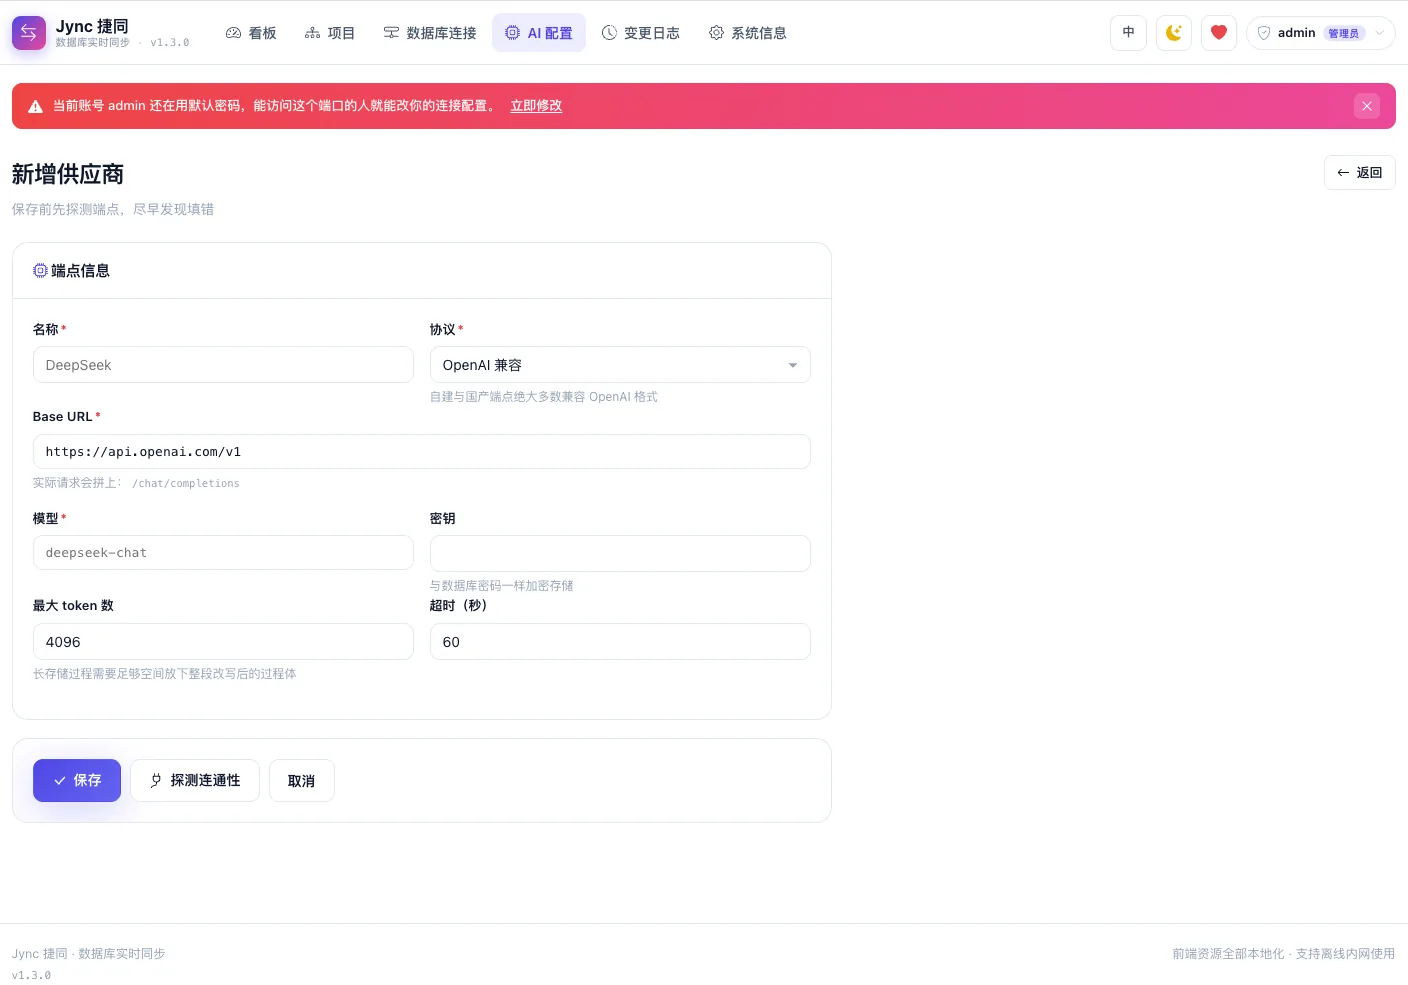
新增供应商:保存前先探测端点
新增 AI 供应商时,保存前会发一次真实请求探测端点,而非 TCP 探活 —— 密钥错误、模型名写错、Base URL 差一段路径这三类问题只有真发请求才暴露得出来。
- 密钥与数据库密码同样 AES-256 加密存储
- 探测不通过无法保存,配错当场知道
- 多供应商共存,同一时刻只启用一个
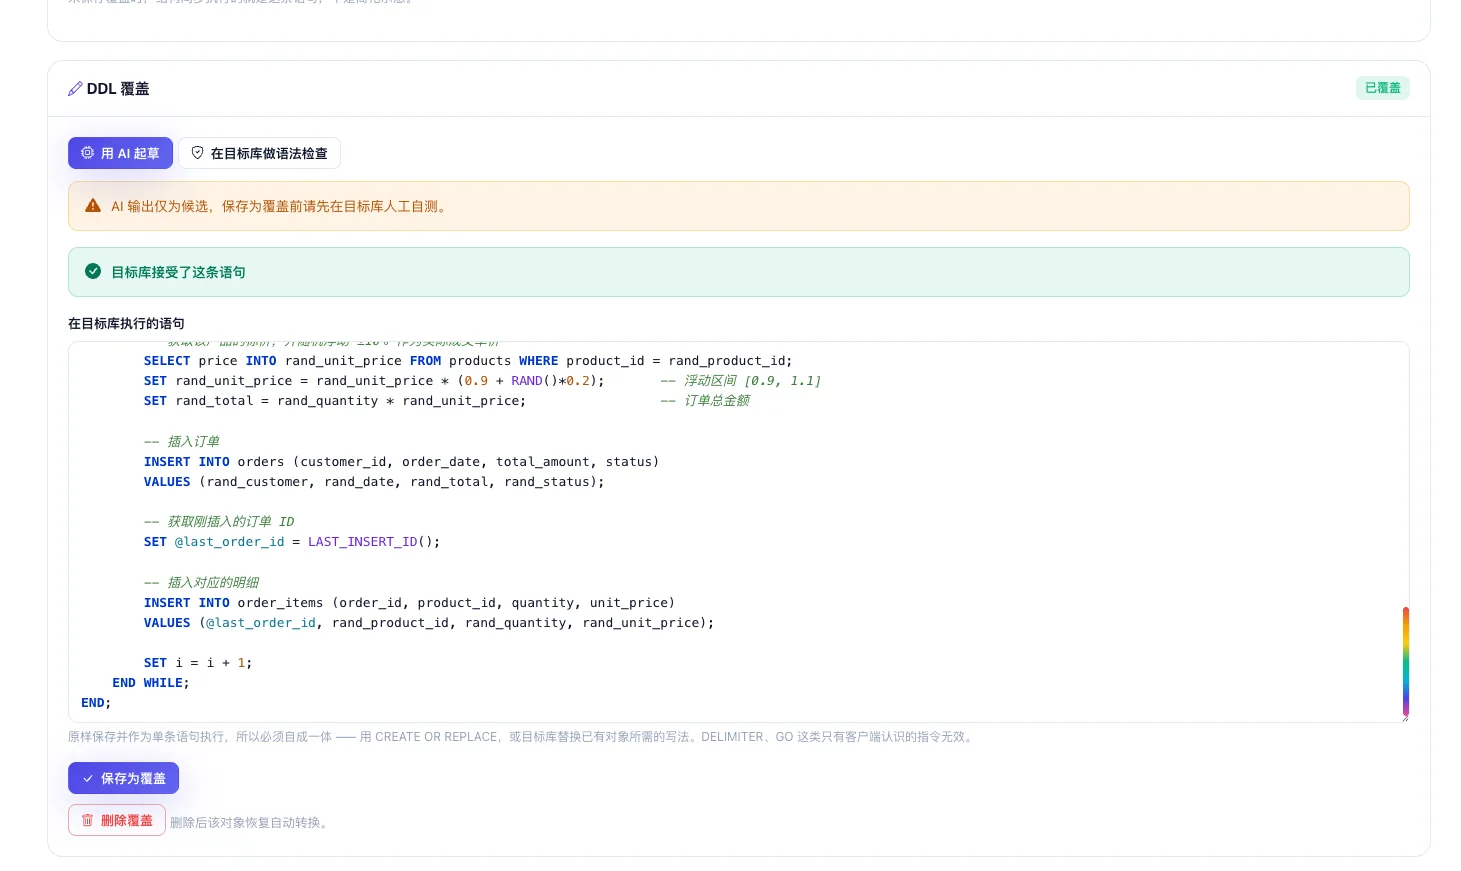
AI 起草:候选 SQL 流式进编辑器
复审页「用 AI 起草」把源过程体发给启用的供应商,候选边生成边渲染进编辑器,不再等超时才一次性看到全文。起草完成后页面只留一条提醒:AI 输出仅为候选,保存为覆盖前请先在目标库人工自测。
- 流式(SSE)输出;整段返回的缓冲型网关自动回退为全文渲染
- 10 分钟起草缓存:同对象重复点击立即返回
- 编辑器带 DBeaver 风格 SQL 高亮;绿条是目标库语法检查的接受结果
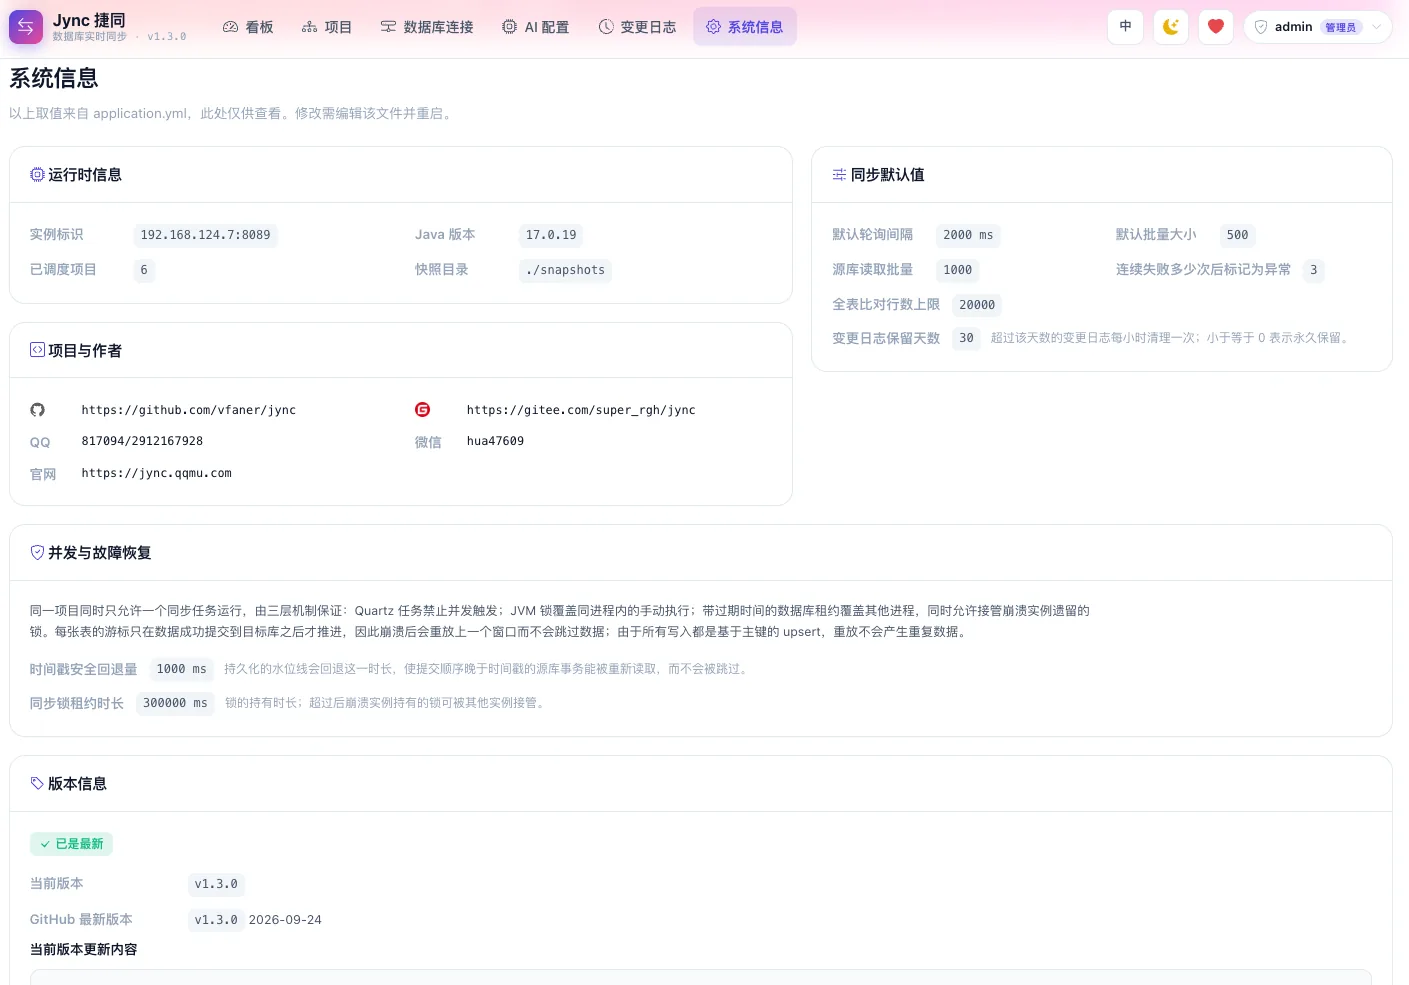
系统信息:运行参数与版本一目了然
原「设置」菜单改名为「系统信息」:实例标识、Java 版本、已调度同步任务数、同步默认参数与并发恢复机制集中只读展示;版本信息卡片显示当前版本、GitHub 最新版本和本版更新内容。更新检查在后台进行,不拖慢页面,纯内网也能看当前版本和更新内容。
- 运行参数集中只读展示
- 版本卡片:当前版本 / GitHub 最新版本 / 本版更新内容
- 可用
--app.update-check.enabled=false关闭更新检查